엔비디아가 로봇 학습 데이터 제작 비용을 최대 125분의 1 수준으로 줄일 수 있는 오픈 모델 제품군 ‘플로라(Flora)’를 선보였다. 사람과 로봇의 작업 영상을 분석해 동작과 발생 시점, 작업 성공 여부, 실패 원인 등을 자동으로 기록한다. 고품질 데이터 확보에 필요한 비용과 시간을 줄여 로봇 파운데이션 모델 개발과 물리적 AI 연구를 앞당기는 것이 목표다.
엔비디아는 20일(현지시간) 플로라를 공개했으며, 모델 가중치는 허깅페이스에 배포했다.
플로라는 엔비디아의 휴머노이드 로봇용 파운데이션 모델 ‘GR00T’ 학습에 실제로 쓰이는 데이터 엔진이다. ‘GB300’ GPU 서버 512개를 이용해 하루 최대 20만 시간 분량의 영상을 처리할 수 있다.
로봇 파운데이션 모델을 학습시키려면 영상만으로는 부족하다. 각 동작이 일어난 시점과 작업 수행 정도, 실패 지점 등을 설명하는 정밀한 데이터가 필요하다. 지금까지는 사람이 영상을 직접 분석하거나 비용이 많이 드는 대형 멀티모달 모델 API를 활용하는 경우가 많아 대규모 데이터를 확보하기 어려웠다.
플로라는 이 과정을 자동화하도록 세 가지 모델로 구성됐다. ‘플로라-템프세그(Flora-TempSeg) 9B’는 영상에서 작업과 세부 동작이 일어나는 구간을 나눈다. ‘플로라-캡셔너(Flora-Captioner) 27B’는 각 구간에 시간 정보를 담은 동작 설명을 만든다. ‘플로라-리워더(Flora-Rewarder) 27B’는 동작의 품질과 진행 상황을 평가하고, 작업의 성공 여부와 실패 원인을 분석한다.
예를 들어 로봇이 물체를 집는 영상을 입력하면, 플로라는 집기 동작의 시작 시점과 물체를 제대로 잡았는지 여부, 미끄러지거나 실패한 단계 등을 기록할 수 있다. 사람의 시점으로 촬영한 영상과 로봇 작업 영상 모두 처리하므로 여러 환경에서 모은 데이터를 학습에 활용하기도 쉽다.
플로라가 만든 데이터는 로봇 모델의 사전 학습, 강화학습, 실제 배포 환경에서의 성능 평가 등 여러 단계에 활용된다. 시간 정보가 담긴 캡션은 사전학습 데이터의 필터링과 균형 조정에 쓸 수 있다. 단계별 보상 점수는 강화학습 사후학습에서 동작을 개선하는 데 도움이 된다. 작업 결과에 대한 보상과 실패 원인 분석은 실제 환경에서 로봇의 수행 능력을 모니터링하는 데 활용된다.
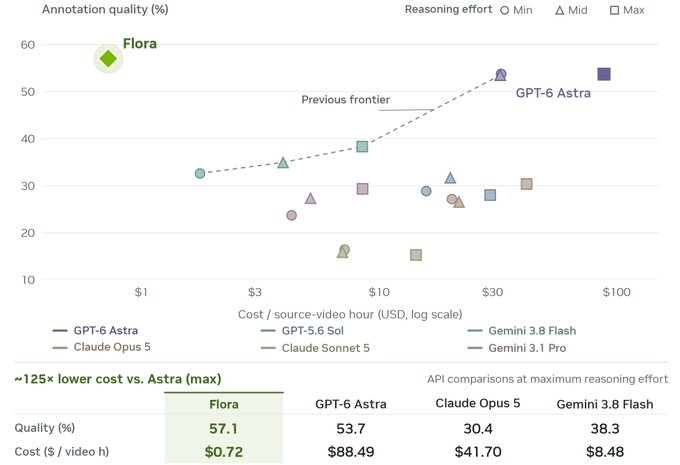
엔비디아는 자체 평가에서 플로라의 데이터 주석 품질이 고성능 상용 모델에 필적했다고 밝혔다. 50개 에피소드를 대상으로 한 평가에서 플로라는 57.1%를 기록해 ‘GPT-6 아스트라’의 최대 추론 노력 설정 결과인 53.7%를 웃돌았다.
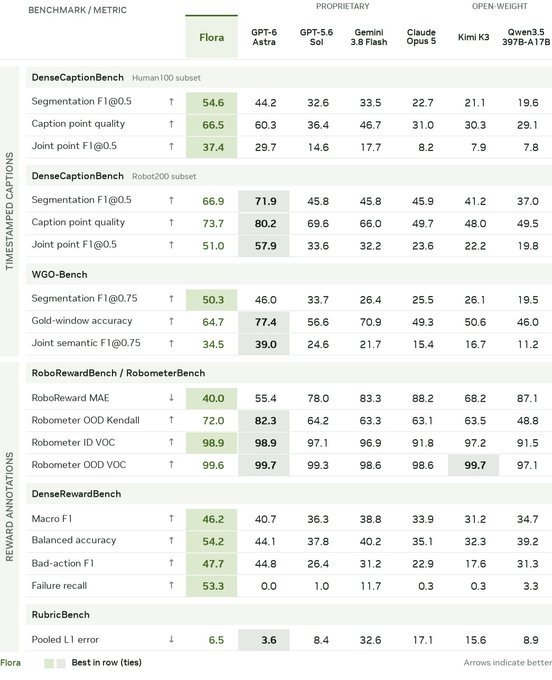
세부 벤치마크의 결과는 항목별로 달랐다. 사람의 작업 영상에서 동작 구간을 분할하는 성능은 플로라가 앞섰지만, 로봇 영상의 일부 평가 항목에서는 아스트라가 더 높은 점수를 얻었다.
보상 평가 결과에도 차이가 있었다. ‘로보리워드(RoboReward)’ 벤치마크에서 플로라의 평균절대오차(MAE)는 40.0으로, 아스트라의 55.4보다 낮았다. 오류 사례를 찾아내는 능력을 측정하는 ‘덴스리워드벤치(DenseRewardBench)’에서는 플로라의 실패 탐지 재현율이 53.3%였다. 엔비디아는 이 같은 성능을 토대로 플로라가 로봇 학습 데이터의 품질 관리와 평가 자동화에 활용될 수 있다고 설명했다.
엔비디아는 비용 차이도 강조했다. 제시한 추정치에 따르면 GB300 GPU 8개를 시간당 10달러에 사용하는 조건에서 플로라의 영상 처리 비용은 원본 영상 1시간당 약 0.72달러다.
같은 분량을 GPT-6 아스트라의 최대 추론 노력 설정으로 처리하면 약 88.49달러가 든다. 이를 기준으로 계산하면 플로라의 비용은 약 122~125배 낮다.
모델 가중치는 허깅페이스의 엔비디아 플로라 저장소에서 내려받을 수 있다. 공개 라이선스는 엔비디아의 비상업용 라이선스로, 연구 목적으로만 이용할 수 있다. 상업적 사용과 실제 제품 환경에서의 활용은 지원되지 않는다.
플로라가 생성하는 결과는 로봇을 직접 제어하는 명령이 아니라 데이터 주석과 평가를 위한 정보다. 또한 안전성을 판단하는 유일한 수단으로 사용해서는 안 된다고 엔비디아는 설명했다.