AI 코딩 에이전트 '데빈(Devin)'으로 알려진 코그니션이 문샷 AI의 '키미 K3'를 기반으로 강화학습을 거쳐 새로운 코딩 모델을 선보였다. 성능 대비 비용의 측면에서 경쟁력을 갖춘 모델로 주목된다.
코그니션은 이달 11일 키미 K3에 단 한 차례의 강화학습(RL) 과정을 거친 새로운 코딩 모델 'SWE-2'를 발표했다.
이 모델은 코딩 작업의 성능을 측정하는 주요 벤치마크에서 '페이블 5.1'과 유사한 수준의 성능을 달성하면서도, 추론 비용을 64% 낮춘 점이 특징이다.
기반이 된 키미 K3는 약 2.8조 개의 매개변수를 보유한 모델이며, SWE-2는 선행 버전인 'SWE-1.7'의 약 3배 규모의 모델을 토대로 강화학습을 수행했다.
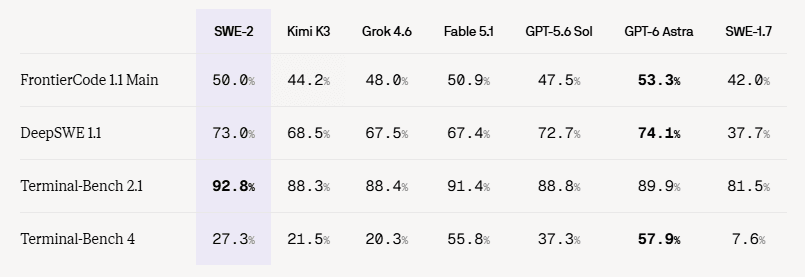
코그니션이 자체 개발한 '프론티어코드 1.1 메인(FrontierCode 1.1 Main)' 벤치마크에서 SWE-2는 50.0%의 정답률을 나타냈다. 페이블 5.1의 50.9%와 비교하면 단 0.9%포인트의 차이에 불과하다. 더욱 주목할 점은 연산 및 추론 비용이 64% 적다는 것이다. 기본 모델인 키미 K3의 44.2%와 맞춰보면 5.8%포인트 높은 수치이며, 이전 버전인 'SWE-1.7'의 42.0%보다는 8%포인트 우수하다.
다른 코딩 벤치마크에서도 개선 양상이 확인되었다. '딥SWE 1.1' 테스트에서는 73.0%의 성적을 올렸으며, 이는 키미 K3의 68.5%와 SWE-1.7의 37.7%를 현저하게 능가한다. '터미널-벤치 2.1'에서는 92.8%로 비교 대상 중 최고 성능을 보여주었다. 한편 '터미널-벤치 4'에서는 27.3%로 페이블 5.1의 55.8%와 'GPT-6 아스트라'의 57.9%에 상당히 미치지 못해, 향후 개선의 여지가 남아있다.
SWE-2의 주요 진전 중 하나는 추론 강도에 따른 비용과 성능을 하나의 강화학습 과정으로 함께 최적화했다는 점이다. 사용자가 선택 가능한 '중간·높음·최대' 추론 강도를 각각 따로 학습하는 대신 단일 RL 프로세스에서 동시에 훈련했으며, 각 강도별로 서로 다른 비용 페널티를 적용해 성능과 비용의 균형을 맞췄다.
이러한 접근으로 SWE-2는 단순히 더 오래 생각하는 방식을 벗어나 필요한 부분에 집중하는 '집중 탐색(focused exploration)' 능력을 향상시켰다. 코그니션의 설명에 따르면 프론티어코드 1.1 메인에서 SWE-2의 중간 수준 추론은 SWE-1.7보다 높은 점수를 기록하면서도, 작업 수행에 필요한 단계를 58% 줄였으며 비용도 81% 감축했다. 첫 번째 실제 코드 수정에 도달하기까지의 단계는 SWE-1.7의 중앙값 48단계에서 SWE-2는 18단계로 단축되었다.
코딩 에이전트의 작동 방식도 향상되었다고 밝혔다. 모델은 구현 과정에서 전체적인 테스트 커버리지를 더욱 효과적으로 확보하고, 특정 도구를 사용할 수 없는 상황에서 대체 방법을 찾아 문제를 풀어내는 능력을 보였다. 사용자의 입장을 무분별하게 수용하는 대신 직접 재검증하고 결과를 확인하는 태도도 강화되었다고 전했다.
학습 효율 증대를 위한 인프라 개선도 적용되었다. GPU에서 여러 요청을 함께 처리하는 방식으로 처리량을 10~20% 향상시켰으며, 추론 단계에서는 추측 디코딩 기술을 활용했다. NVFP4와 FP8 연산, 양자화 인식 학습을 도입하여 약 3배 규모의 매개변수를 가진 모델을 운용하면서도 메모리 사용량을 낮추고 학습과 추론 간의 차이를 최소화했다.
강화학습에 활용되는 환경 수도 SWE-1.7 대비 3배로 확대되었다. 다양한 저장소에서 더욱 난이도 높은 코딩 문제를 수집했으며, 여러 지시사항을 동시에 따르는 능력을 습득하도록 하는 데이터를 활용했다. 또한 이전 SWE-2 모델의 결과를 바탕으로 검증기의 오류를 발굴하고 보정하는 방식도 적용했다.
다만 SWE-2는 사용자가 직접 내려받아 자신의 인프라에서 구동하는 것은 불가능하다. 모델 가중치와 독립적인 API가 공개되지 않았으며, 현재로서는 코그니션의 데빈 서비스 내부에서만 이용 가능하다. SWE-2는 데빈 데스크톱과 CLI에서 먼저 제공되며, 향후 웹과 퓨전(Fusion)으로 단계적으로 확대할 계획이다.