텐센트는 최근 텍스트를 음성으로 바꾸는 것은 물론, 기존 음성의 내용과 음색, 감정, 억양 같은 요소를 자연어 명령 하나로 수정할 수 있는 오픈소스 AI 모델을 발표했습니다. 하나의 모델에서 음성 생성과 편집을 통합 처리한다는 특징을 내세우며 '오디오용 나노바나나(Nano Banana for Audio)'라는 별칭을 붙였습니다.
텐센트는 10일(현지시간) 음성 생성 및 편집을 하나로 묶은 기반 모델 'AuK'를 공개했습니다. 이 모델은 자연어 명령과 참조 오디오를 단일 인터페이스에서 처리하는 통합형입니다. 종래에는 음성 생성, 편집, 음질 개선 같은 작업에 제각각 다른 모델이나 도구를 써야 했지만, AuK는 이런 기능들을 모두 하나의 모델로 처리하도록 만들어졌습니다.
텍스트를 음성으로 변환하는 제로샷 TTS는 물론 사용자의 자연어 명령에 따른 음성 생성도 가능합니다. 원하는 목소리의 참조 음성을 제공하면 이를 바탕으로 새로운 문장의 음성을 만들어낼 수도 있으며, 기존 음성의 특정 부분을 수정하거나 스타일을 바꾸는 작업도 자연어 명령으로 진행할 수 있습니다.
음성 편집 기능의 범위도 상당히 넓습니다. 음성의 내용을 삽입·삭제·교체하거나, 음색과 스타일, 감정을 변경할 수 있으며, 지역 발음을 표준 발음으로 정정하거나 억양을 조정하는 작업도 지원합니다. 음성 속도와 음높이 조절, 속삭이는 톤으로의 변환 같은 기능도 함께 제공됩니다.
가장 눈에 띄는 기능은 음성 콘텐츠를 부분적으로 수정할 수 있다는 점입니다. 녹음한 대사에서 단어 하나를 잘못 발음했을 경우, 기존에는 해당 부분을 고치려면 문장 전체를 다시 녹음하거나 새로 생성해야 했습니다. 하지만 AuK를 쓰면 자연어 명령만으로 필요한 부분만 선택적으로 수정할 수 있습니다.
음성 향상과 잡음 제거, 다중 화자 분리, 음악과 보컬 분리 같은 기능도 함께 지원합니다. 텐센트는 순수 음성뿐 아니라 일반 오디오와 음악까지 아우르는 하나의 기반 모델을 구축했다고 강조했습니다.
학습에는 30억3000만개의 지시어-오디오 데이터와 195만 시간에 이르는 오디오 학습 데이터가 활용되었습니다. 이들 데이터는 음성 생성, 콘텐츠 편집, 음성 특성 편집, 음향 편집, 음질 개선·분리 등 5개 영역으로 구성되었으며, 공개 데이터뿐 아니라 자체 녹음 데이터와 합성 데이터도 포함되었습니다. 음성 인식과 화자 확인을 통한 품질 검증 과정도 거쳤습니다.
모델 구조는 음성의 의미를 파악하는 멀티모달 대형언어모델(MLLM), 음성·일반 오디오·음악의 특성을 처리하는 VAE(변분 오토인코더), 실제 오디오를 만드는 하이브리드 트랜스포머로 이루어져 있습니다. 이를 통해 텍스트만으로 음성을 생성하는 방식과 텍스트와 참조 음성을 함께 쓰는 음성 편집 방식을 동일한 모델에서 처리할 수 있게 설계되었습니다.
인간의 선호도를 반영하는 RLHF와 강화학습도 적용되었습니다. 음성 편집에서는 자연스럽다고 평가받은 결과를 학습시켰고, 음성 생성에서는 콘텐츠 정확성과 화자 유사성 등을 보상으로 활용해 성능을 높였습니다.
빠른 처리를 위한 경량화 버전인 'AuK-플래시(Flash)'도 함께 공개되었습니다. 원래 모델의 성능을 유지하면서 추론 단계를 4단계로 단축한 이 모델은 동일한 조건에서 전체 AuK 모델보다 약 4.5배 빠르게 음성을 생성할 수 있습니다.
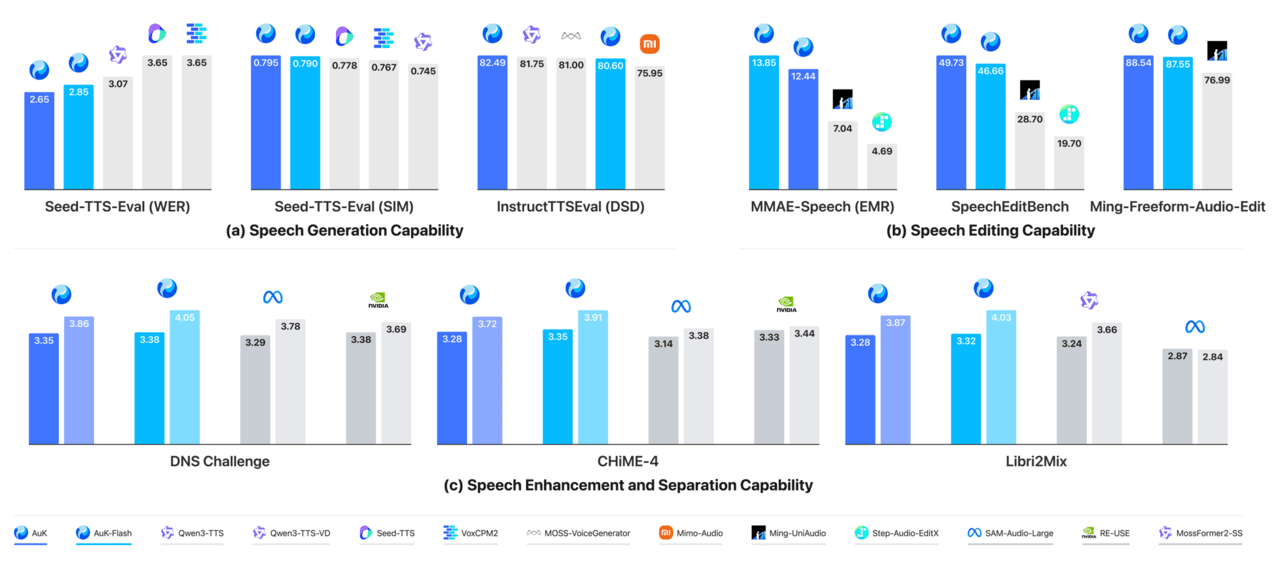
성능 평가 결과를 보면 AuK는 제로샷 TTS, 지시어 기반 음성 생성, 자연어를 활용한 음성 편집 등에서 기존 모델들을 능가한다고 텐센트는 밝혔습니다. 특히 음성 콘텐츠 편집에서 언어적 정확성과 사용자의 지시를 따르는 능력이 크게 개선되었으며, AuK-플래시는 빠른 처리 속도를 유지하면서도 음질과 편집 품질에서 경쟁력 있는 수준을 보여주고 있습니다.
AuK와 AuK-플래시는 허깅페이스를 통해 모두 오픈소스로 공개되었습니다. 텐센트는 모델 가중치와 소스코드, 데모를 제공하여 개발자와 연구자들이 직접 모델을 활용하거나 추가 연구에 사용할 수 있도록 했습니다.