대형언어모델(LLM)의 추론 역량에 강화학습과 과학 도구를 접목해 새로운 소재를 찾으려는 연구가 이어지는 가운데, 피어리오딕 랩스(Periodic Labs)가 재료과학에 특화된 AI 모델을 공개했다.
오픈AI 출신 리암 페더스가 설립한 피어리오딕 랩스는 15일(현지시간) 재료과학 연구에 특화된 AI 모델 ‘네온(Neon)’을 선보였다.
피어리오딕 랩스는 AI 모델 개발에 그치지 않고, 장시간 추론과 과학 도구 실행이 필요한 연구 환경에 맞춰 학습·추론 인프라까지 최적화했다. 이를 통해 신소재를 탐색하는 데 걸리는 시간을 줄이는 것이 목표다.
네온은 공개 가중치 모델을 바탕으로 중간학습과 강화학습(RL)을 거쳐 완성됐다. 최종 학습에는 최대 1300개의 'H200' GPU가 사용됐으며, 회사 측은 X선 회절(XRD) 평가에서 'GPT-6 아스트라'와 '페이블 5.1' 등 최첨단 범용 모델을 넘어서는 성능을 확보했다고 밝혔다. 다만 이 성능 평가는 피어리오딕 랩스가 자체적으로 제시한 결과다.
현재 네온은 피어리오딕 랩스의 고처리량 실험실에서 실제 실험 결과를 분석하는 데 사용되고 있다. 회사는 이를 활용해 더 나은 초전도체와 자석 소재를 찾고, 연구 아이디어가 실제 실험 결과로 연결되기까지의 시간을 단축할 계획이다.
네온의 핵심 특징은 모델의 규모뿐 아니라 과학 연구에 최적화된 AI 인프라에도 있다. 피어리오딕 랩스는 메가트론(Megatron), SGLang, Miles, Ray 등 오픈소스 프레임워크를 기반으로 자체 시스템을 구축했으며, 과학 분야 강화학습에서 나타나는 장시간·가변 길이 추론에 맞춰 시스템을 크게 개조했다.
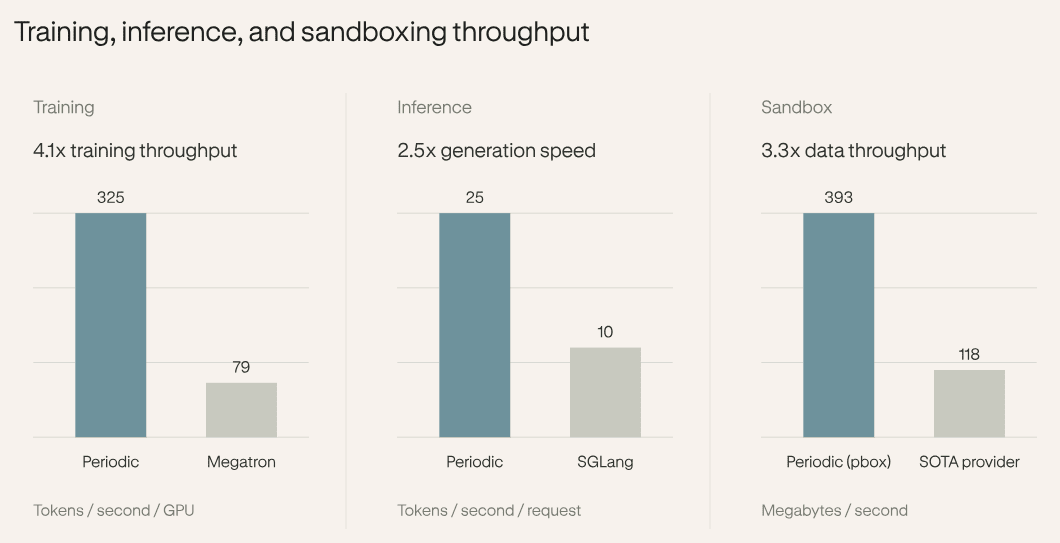
회사 측에 따르면 학습 스택은 동일한 GPU 환경에서 메가트론 기반 시스템보다 최대 4.1배 높은 학습 처리량을 달성했다. SGLang을 최적화해 추론 속도 역시 특정 사용 환경에서 2.5배 높였다. 또한 학습과 추론을 서로 다른 GPU 자원에서 비동기적으로 동시에 수행하도록 구성해, AI가 과학 도구를 활용하며 장시간 추론하는 강화학습 환경에서도 GPU 활용도를 끌어올렸다.
GPU 메모리 효율도 향상했다. 텐서 병렬화(TP), 파이프라인 병렬화(PP), 전문가 병렬화(EP) 등을 조합해 대규모 모델을 분산 처리하고, 선택적 재계산과 FP8 가중치 등을 적용했다. 그 결과 64개 GPU에서 6만4000토큰 컨텍스트를 처리할 때 최대 메모리 요구량을 320GB에서 132GB로 줄였다. 피어리오딕 랩스는 이를 바탕으로 64개의 H200 GPU만으로 1조개 매개변수 규모의 '키미 K2.6' 전체 매개변수 학습이 가능했다고 설명했다.
과학 연구에 필요한 코드와 도구를 안전하게 실행하기 위한 자체 샌드박스 ‘pbox’도 개발했다. pbox는 별도의 샌드박스 서버를 구축하는 대신 강화학습 작업에 이미 할당된 GPU 노드의 유휴 CPU 자원을 활용한다. 모델이 생성한 코드가 과도한 메모리를 사용하거나 오류를 발생시키더라도 전체 학습·추론 작업에 영향을 주지 않도록 격리하는 방식이다.
내부 테스트에서 100개의 샌드박스를 대상으로 1MiB 파일을 업로드하고 다운로드한 결과, pbox는 비교 대상으로 삼은 호스팅 샌드박스 서비스보다 중간값 기준 데이터 전송 지연이 4.5배 낮았다. 전체 처리량은 3.3배 더 높았다.
추론 시스템은 장시간 강화학습을 염두에 두고 설계됐다. 생성과 학습을 동시에 수행하는 ‘파이프라인RL(PipelineRL)’ 방식을 적용했으며, KV 캐시를 재사용해 반복 계산을 줄였다. 여기에 ‘델타 라우터 리플레이(Delta router replay)’를 도입해 이미 처리한 부분의 라우팅 정보를 다시 전송하지 않고 새로 생성된 부분만 처리하도록 했다.
이 같은 최적화로 1조개 매개변수 모델에서 동일한 배치 크기를 유지하면서 디코딩 속도를 초당 10토큰에서 25토큰으로 2.5배 끌어올렸다. 대규모 모델의 체크포인트를 추론용 형식으로 변환하는 데 걸리는 시간도 30분에서 1분으로 줄였다고 밝혔다.
피어리오딕은 연구용 AI 인프라의 상당 부분을 오픈소스 생태계에 기여하며 지속적으로 발전시킬 방침이다. 이미 개선한 기술 일부를 Megatron-LM, SGLang, Miles 등에 다시 기여했으며, 앞으로 다중 에이전트 강화학습, 저정밀도 모델 최적화, 분산 KV 캐시, 수천개 규모의 과학 도구 샌드박스 확장 등을 추진할 계획이다.