구글이 AI 에이전트의 문제 해결 과정에 재귀적 자기개선(RSI)을 적용하면서 탐색에 드는 실행 비용을 크게 낮추는 새로운 방법을 공개했다.
구글은 17일(현지시간), AI 코딩 및 문제 해결(탐색) 에이전트가 실패한 경로를 계속 다시 실행하며 막대한 연산 비용을 소모하는 문제를 해결하기 위해 과거 탐색 기록을 재활용하는 ' 드림-RSI(Dream-RSI) ' 시스템을 선보였다.
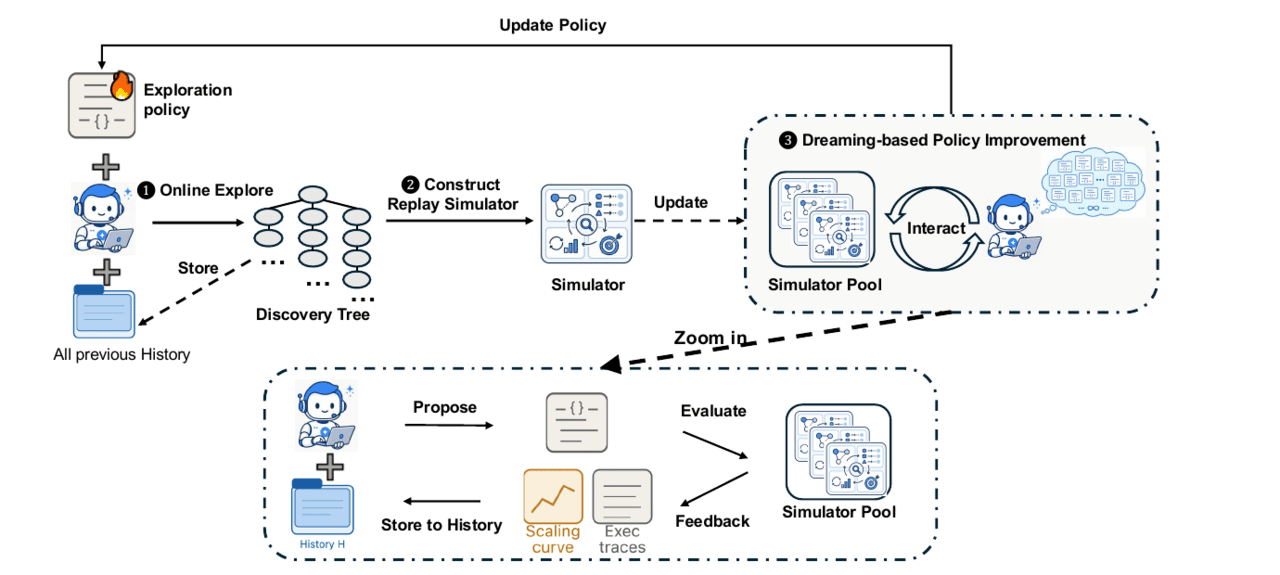
핵심은 과거 탐색 기록을 일종의 시뮬레이터로 활용해 실제 코드 실행 없이 수천 개의 새로운 탐색 전략을 평가하는 데 있다.
RSI는 AI가 문제를 해결하는 과정에서 얻은 결과를 토대로 다음 탐색 전략을 개선하는 방식이다. 그러나 기존 방식에서는 새로운 탐색 정책의 성능을 확인하려면 코드를 실제로 다시 실행하고 전체 탐색 절차를 반복해야 했다. 수천 번의 제안과 평가가 이어지는 탐색에서는 이미 실패한 경로에도 연산 비용을 거듭 지불해야 한다는 문제가 발생했다.
드림-RSI는 과거 기록을 단순한 텍스트나 학습 데이터로 사용하지 않는다. 연구진은 이전 탐색 과정에서 에이전트가 내린 모든 결정과 실제 코드 실행 결과를 ‘발견 트리(Discovery Tree)’라는 구조에 저장한 뒤, 이를 재생할 수 있는 ‘리플레이 시뮬레이터’로 변환했다. 이미 실행 결과가 기록돼 있으므로 새로운 탐색 정책이 과거와 다른 경로를 택하더라도 해당 결과를 다시 실행할 필요가 없다.
연구진은 이 과정을 ‘꿈(Dreaming)’ 단계라고 설명했다. 에이전트는 실제 환경에서 새로운 탐색을 수행하는 대신 과거에 구축한 발견 트리를 따라가며 여러 정책을 가상으로 적용하고 평가한다. “모든 실행 결과가 이미 트리에 저장돼 있기 때문에 새로운 전략을 평가하려면 과거 기록을 읽기만 하면 되며, 기본 검색 에이전트(underlying discovery agent)나 평가기(evaluator)를 다시 실행할 필요가 없다”고 설명했다.
드림-RSI는 온라인 탐색, 리플레이 시뮬레이터 구축, 꿈 기반 정책 개선 등 크게 세 단계로 작동한다. 우선 탐색 정책에 따라 실제 문제를 해결하며 발견 트리를 만들고, 이를 재사용할 수 있는 기록 저장소에 추가한다. 이어 AI가 여러 대안 정책을 만들어 과거 기록에 적용한 뒤 성능을 비교한다. 가장 우수한 정책은 다시 실제 탐색에 투입되고, 그 결과 새로운 발견 트리가 추가된다. 탐색 경험이 쌓일수록 AI가 활용할 수 있는 ‘세계’도 함께 확장되는 구조다.
연구진은 알고리즘 엔지니어링, 수학적 최적화, GPU 커널 엔지니어링 등 8개 탐색 과제를 대상으로 드림-RSI를 평가했다. 실험 결과, 기존의 고정 탐색 방식과 비슷하거나 더 뛰어난 문제 해결 성과를 내면서 연산량과 에이전트 호출을 줄일 수 있었다. 특히 기존 심플TES(SimpleTES)와 비교했을 때 최대 162배 적은 탐색 에이전트 호출만으로 비슷한 수준의 발견 성과를 달성했다.
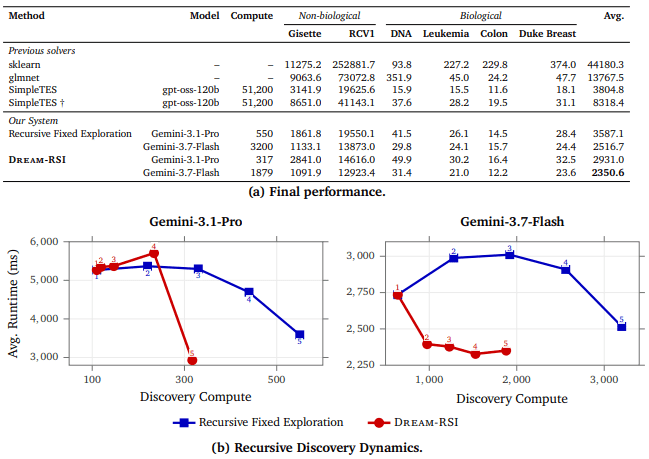
라쏘(Lasso) 탐색 실험에서 '제미나이-3.1-프로'를 사용한 경우 평균 실행 시간은 3587.1밀리초(ms)에서 2931.0ms로 짧아졌고, 탐색 에이전트 호출 횟수도 550회에서 317회로 감소했다. '제미나이-3.7-플래시'에서는 평균 실행 시간이 2516.7ms에서 2350.6ms로 줄었으며 호출 횟수는 3200회에서 1879회로 낮아졌다.
GPU 커널 엔지니어링에서도 성과가 확인됐다. VGG16과 LayerNorm에서는 각각 2.43배와 1.79배 적은 생성으로 비슷한 성능을 냈고, ConvDiv와 ConvMax에서는 비슷한 예산으로 각각 2.09배와 1.44배 더 높은 성능을 기록했다.
ConvDiv 실험에서는 진행이 정체되자 탐색 규모를 다시 키우는 등 성과에 따라 연산량을 조절하는 적응형 탐색 전략도 나타났다.
연구진은 과거 경험을 프롬프트에 삽입하거나 모델 학습 데이터로 사용하는 기존 방식과 달리, 드림-RSI는 탐색 이력 자체를 실행 가능한 시뮬레이션 환경으로 활용한다고 강조했다. “히스토리는 꿈꿀 수 있는 세계(History is the world to dream in)”라며 “에이전트가 이미 구축한 발견 트리는 에이전트가 도달했던 탐색 공간의 정확한 시뮬레이터”라고 설명했다.
다만 발견 트리에 포함되지 않은 영역까지 시뮬레이션할 수 있는 것은 아니다. 과거 탐색이 실제로 도달한 공간 안에서만 새로운 정책을 평가할 수 있기 때문이다.
연구진은 이를 보완하기 위해 새로운 정책을 실제 환경에 다시 적용하고, 새로운 발견 트리를 계속 축적하는 순환 구조를 제안했다. AI가 탐색하고 기록한 경험이 다시 다음 탐색 전략을 개선하는 기반으로 활용되는 방식이다.