
메타가 사용자 정보를 기억하고 복잡한 작업을 이어가는 데 중점을 둔 AI 모델 ‘뮤즈 원더(Muse Wonder)’와 ‘뮤즈 원더 풀(Muse Wonder Full)’을 선보였다. 독립 평가에서 선두권 성적을 거두며 오픈AI·앤트로픽과의 경쟁에 뛰어들었다. 다만 가장 강력한 풀 모델은 자사 코딩 도구 구독자만 사용할 수 있어, 기술적 성과가 시장 확산과 구독 수익으로 이어질지가 관건이다.
메타는 12일(현지시간) 뮤즈 원더 시리즈를 발표했다. 일반 원더 모델은 메타 모델 API와 ‘뮤즈 코드(Muse Code)’에서 제공한다. 상위 모델인 원더 풀은 뮤즈 코드 구독자에게만 열리며 공개 API로는 사용할 수 없다. 개인 AI 에이전트 ‘뮤즈(Muse)’에도 원더를 적용하고, 구독자에게 먼저 제공할 계획이다.
이번 모델은 알렉산드르 왕 CAIO가 이끄는 MSL이 개발한 자체 최고 모델이라는 점에서 눈길을 끈다. 기존 ‘뮤즈 스파크’ 제품군보다 규모가 훨씬 크고 성능이 발전한 상위 버전으로 볼 수 있다.
메타는 AI 개발 체계를 전면 개편한 지 14개월 만에 기반을 다시 세우는 단계를 넘어 프런티어 경쟁에 진입했다고 강조했다. 두 모델은 오하이오주의 프로메테우스 데이터센터에서 훈련됐다.
핵심 기능은 ‘액티브 메모리(Active Memory)’와 ‘액티브 포커스(Active Focus)’다. 액티브 메모리는 대화가 이어지는 동안 중요한 사용자 정보와 업무 정보를 기억해 필요할 때 활용하는 기능이다. 액티브 포커스는 작업 중 오류나 장애물이 생겨도 다른 방법을 찾아 목표를 계속 수행하는 능력을 가리킨다.
왕은 CNBC 인터뷰에서 실제 업무에는 예기치 않은 장애물이 생긴다며, 모델이 매번 멈춰 사용자에게 확인을 구하는 대신 다른 방법을 시도하도록 훈련했다고 설명했다. 메타는 이 기능을 예약, 보험 처리, 전문 문서 작성, 장기간 이어지는 소프트웨어 개발 등에 활용할 수 있다고 밝혔다.
두 모델은 텍스트·이미지·영상·음성을 입력받아 텍스트로 출력한다. 컨텍스트 창은 100만 토큰으로, 이전 ‘뮤즈 스파크 1.3’과 같다. 이번에는 컨텍스트 크기를 늘리기보다 정보를 활용하고 작업을 지속하는 능력을 개선하는 데 초점을 맞췄다.
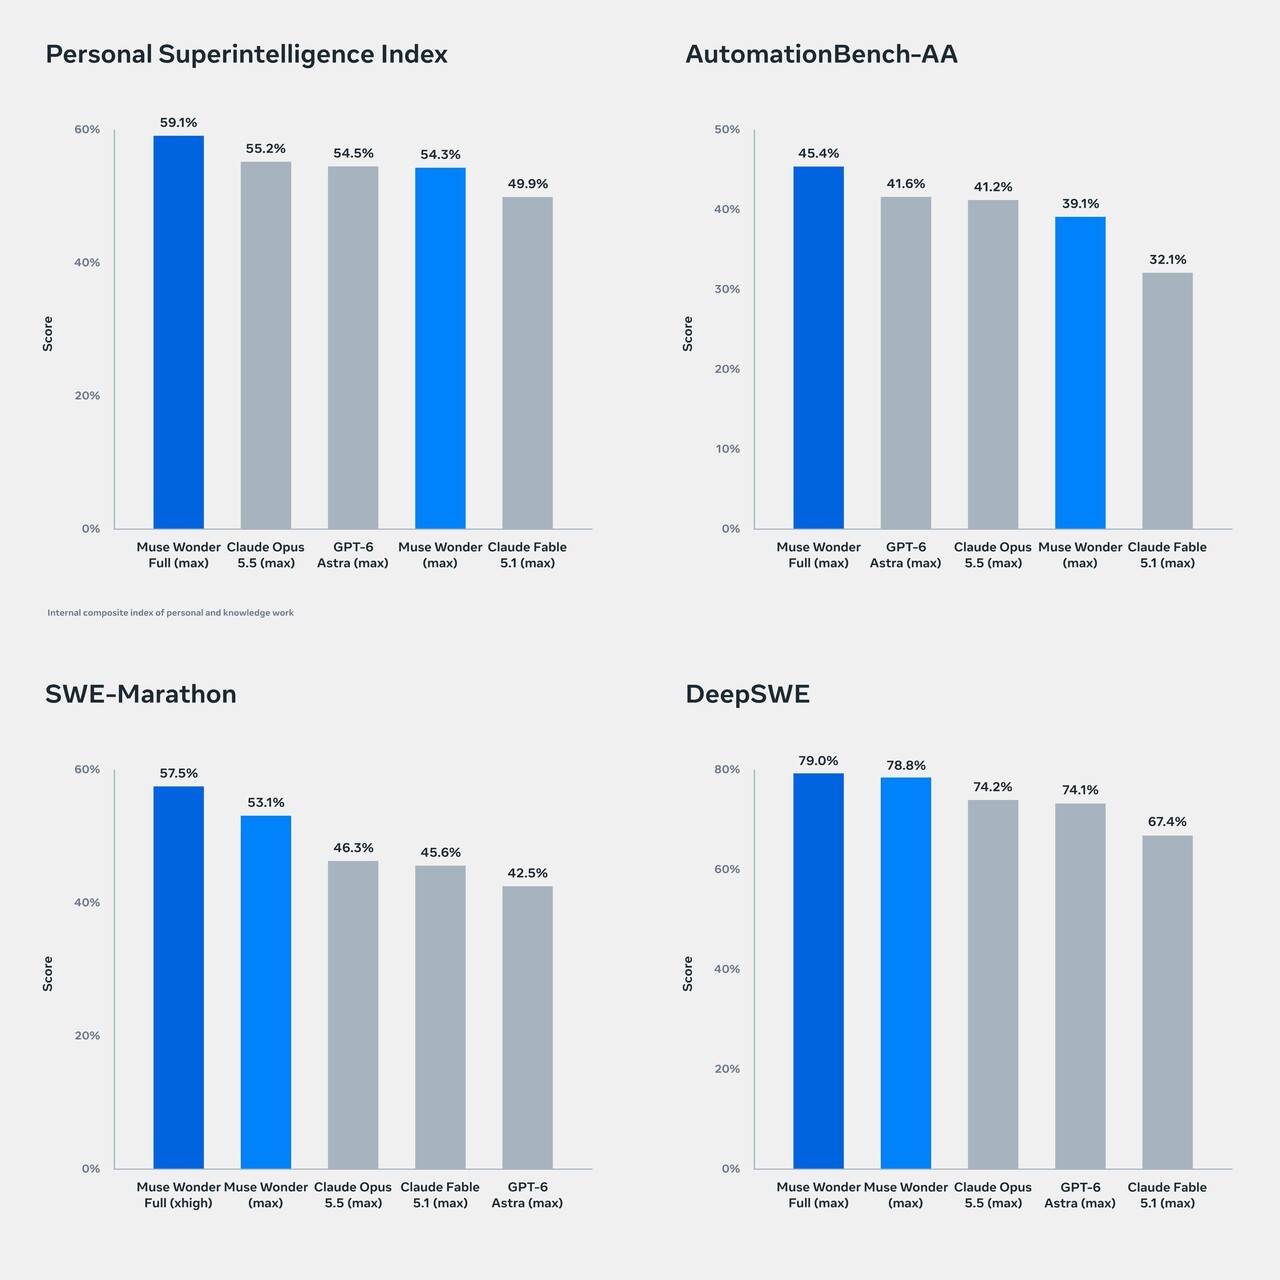
메타가 공개한 벤치마크 결과에서는 장기 소프트웨어 엔지니어링 성능이 특히 돋보였다. ‘딥SWE 1.1’에서 원더 풀은 79.0%, 원더는 78.8%를 기록했다. ‘클로드 오퍼스 5.5’의 74.2%와 ‘GPT-6 아스트라’의 74.1%를 모두 웃도는 수치다.
장기 프로젝트 수행 능력을 측정하는 ‘SWE-마라톤’에서도 풀은 57.5%, 원더는 53.1%를 기록해 오퍼스 5.5의 46.3%와 아스트라의 42.5%를 앞섰다. 다만 메타는 이 평가에서 모델마다 코딩 도구가 달랐고, 풀의 추론 설정도 달라 통제된 동일 조건 비교는 아니라고 밝혔다.
모든 평가에서 앞선 것은 아니다. ‘터미널벤치 4.0’에서 풀은 57.1%를 기록해 오퍼스 5.5의 59.6%와 아스트라의 59.1%에 못 미쳤다. 전문 건강 질문을 평가하는 ‘헬스벤치 프로’에서도 풀의 점수는 62.3%로 두 경쟁 모델보다 낮았다.
독립 평가 기관 아티피셜 애널리시스가 매긴 지능 지수(AAII) v4.3에서는 최대 추론 설정 기준 원더 풀이 56점, 원더가 52점을 받았다. 풀은 클로드 소네트 5.5와 같은 점수를 기록했고, GPT-6 아스트라·제미나이 4 아르곤·클로드 페이블 5.1의 53점보다 높았다. 오퍼스 5.5의 58점에는 뒤졌다.
아티피셜 애널리시스는 6주 전에 나온 스파크 1.3의 48점과 견주면 두 모델 모두 크게 개선됐다고 평가했다. 특히 풀의 터미널벤치 점수는 33%에서 57%로 올랐고, 전문 업무 평가인 ‘GDPval-AA’ 점수도 1681 Elo에서 1857 Elo로 상승했다.
풀은 지능 지수를 이루는 10개 평가 가운데 6개에서 상위 3위에 들었다. 전문 지식 작업과 과학적 추론에서 강점을 나타내면서, 메타가 주장한 에이전트 성능 개선에 외부 평가 결과가 힘을 보탰다.
모델과 코딩 도구를 함께 평가하는 별도의 ‘코딩 에이전트 지수’에서도 뮤즈 코드를 사용하는 풀은 68점, 원더는 63점을 받았다. 스파크 1.3을 적용한 뮤즈 코드의 54점보다 크게 오른 결과다. 이 평가에서 풀은 클로드 코드를 사용하는 소네트 5.5와 같은 68점을 기록했다.
원더의 API 가격은 토큰 100만 개당 입력 4달러, 출력 20달러다. 캐시 입력 가격은 0.20달러다. 오퍼스 5.5와 같은 단가이며, 입력 10달러·출력 50달러인 아스트라와 페이블 5.1보다 낮다.
하지만 토큰 단가가 낮다고 작업 비용까지 저렴한 것은 아니다. 아티피셜 애널리시스 평가에서 원더의 작업당 평균 비용은 4.52달러였다. 오퍼스 5.5의 5.98달러, 페이블 5.1의 7.63달러보다는 낮았지만 아스트라의 3.26달러와 아르곤의 1.99달러보다는 높았다. 이 수치는 해당 평가에서 모델별 토큰 사용량과 가격을 반영한 것이다.
풀은 토큰당 가격이 공개되지 않아 작업당 비용을 비교할 수 없다. 풀을 이용하려면 월 50달러 또는 200달러의 뮤즈 코드 구독이 필요하다. 기업이 풀을 API로 자체 서비스나 자동화 시스템에 연결할 수 없다는 점도 도입을 어렵게 하는 요소다.
주요 외신은 이번 출시를 메타의 기술 경쟁력 회복과 수익화 전략이라는 두 측면에서 다뤘다.
저지연 경량 모델인 스파크에서 대형 프런티어 모델로 도약한 점과 장기 기억 능력이 주목받았다. 반면 풀의 API 접근 제한과 비공개 가중치, 데이터 사용·보존 조건이 실제 도입을 결정할 것이라는 지적도 제기됐다.
소비자가 더 유능한 개인 비서에 비용을 낼지도 주요 쟁점으로 꼽혔다. 뮤즈 앱에서 원더를 사용하려면 월 20달러 또는 100달러 구독이 필요하다. 메타가 온라인 광고에 더해 AI 기반 수익원을 마련하려 한다는 분석이다.
메타의 대규모 인재 영입과 인프라 투자로 구독 매출을 낼 수 있을지도 관심을 모았다. 발표 당일 오후 거래에서 메타 주가는 약 4% 올랐다.
사용자의 신뢰를 얻는 일도 과제로 남았다. CNBC는 일부 이용자가 뮤즈가 개인 메시지에 접근하는 데 불만을 표했다고 보도했다. 메타는 무단 접근 주장을 부인했다. 왕은 사용자가 이전에 부여한 권한을 잊는 경우가 있다며, 제품 사용 안내를 강화하고 있다고 설명했다.
이번 출시로 메타는 프런티어급 성능의 모델과 개인·업무용 에이전트를 결합한 유료 서비스 경쟁에 나섰다. 그러나 독립 평가에서 더 높은 점수를 받은 풀은 이용 경로가 제한돼 있고, 일반 원더의 작업 비용도 경쟁사보다 늘 낮은 것은 아니다. 기억력과 작업 지속성의 개선이 실제 업무 완수율과 반복 이용으로 이어져야 대규모 AI 투자를 새로운 수익원으로 바꿀 수 있을 전망이다.