AI 모델 경쟁이 성능을 넘어 응답 속도와 비용 효율성으로 확대되는 가운데, 확산 대형언어모델(dLLM)이 기존 모델의 한계를 뛰어넘을 가능성을 보여주는 사례가 나왔다. 초고속 생성 능력과 오픈AI·앤트로픽 모델에 맞먹는 성능을 내세우며, 복잡한 AI 에이전트 작업까지 겨냥한 모델이다.
인셉션(Inception)은 19일(현지시간) 초당 1000토큰 이상을 생성하면서 ‘GPT-6 루나’와 ‘클로드 하이쿠 5.5’보다 높은 품질을 낸다고 밝힌 dLLM ‘머큐리 3(Mercury 3)’를 출시했다. 이전 세대보다 모델 규모를 40배 이상 키우면서도 빠른 속도를 유지한 것이 특징이다.
인셉션은 머큐리 3를 “지금까지 출시된 dLLM 가운데 가장 강력하고 지능적인 모델”이라고 소개했다. 자체 벤치마크에서 GPT-6 루나와 하이쿠 5.5보다 높은 품질을 기록하면서 초당 1000토큰이 넘는 생성 속도를 구현했다는 설명이다. 엔비디아 GPU 환경에서 측정한 생성 속도는 초당 1068토큰이다.
핵심 기술은 텍스트를 순서대로 생성하는 대신 여러 위치의 토큰을 병렬로 다듬는 확산 방식이다. 기존 자기회귀(autoregressive) 모델은 앞선 토큰이 생성된 다음에야 다음 토큰을 만들 수 있다. 반면 확산 모델(diffusion model)은 답변 전체의 초안을 만든 뒤 여러 단계를 거쳐 동시에 개선한다. 순차 처리 단계를 줄여 응답 지연을 낮출 수 있다.
인셉션은 머큐리 3가 확산 모델도 규모를 키우면 지능을 높일 수 있음을 보여준다고 강조했다. 첫 번째 모델인 ‘머큐리 1 미니’보다 전체 매개변수 규모를 40배 이상 늘렸고, 두 모델의 표준 벤치마크 평균 성능은 약 3배 향상됐다고 밝혔다. 구체적인 매개변수 수는 공개하지 않았다.
이번 출시를 두고 AI 성능을 높이는 동시에 지연 시간과 비용 부담을 줄이는 새로운 방법이라고 설명했다. 인셉션은 “확산 모델은 지능이 비례적인 지연 시간 증가 없이 성장할 수 있는 새로운 길을 연다”고 밝혔다.
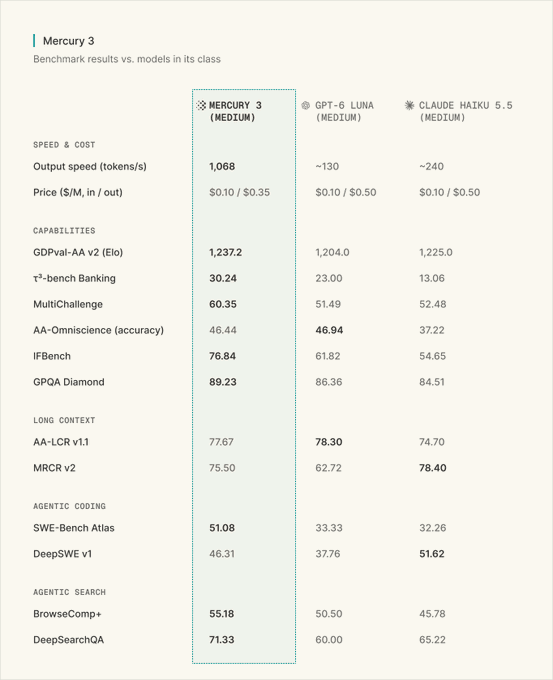
자체 벤치마크에서 머큐리 3는 코딩과 지시 이행 분야에 강점을 보였다. ‘SWE-벤치 아틀라스’ 점수는 51.08로 GPT-6 루나의 33.33, 하이쿠 5.5의 32.26보다 높았다. ‘IF벤치’에서는 76.84점을 기록해 GPT-6 루나를 약 15점 앞섰다. ‘GPQA 다이아몬드’ 점수는 89.23이었다.
다만 모든 평가에서 경쟁 모델을 앞선 것은 아니다. ‘딥SWE v1’에서는 하이쿠 5.5가 51.62점으로 머큐리 3의 46.31점을 웃돌았다. 긴 문맥에서 정보를 찾는 ‘MRCR v2’에서도 하이쿠 5.5가 우세했다. 일부 장문 검색과 복잡한 코딩 작업에는 여전히 개선의 여지가 있다.
머큐리 3는 코드 리뷰, 대화형 교육, 웹 탐색, 실시간 검색, 고객 지원처럼 응답 속도가 중요한 AI 에이전트에 활용할 수 있다. 에이전트는 작업을 수행하면서 모델에 여러 차례 요청을 보내므로 단계별 지연이 쌓이기 쉽다. 인셉션은 응답이 빠르면 웹 탐색이나 문서 분석을 더 신속하게 처리하고, 제한된 시간 안에 여러 접근 방식을 시도할 수 있다고 설명했다.
얼리 액세스 파트너들도 여러 활용 사례를 공개했다. 웹 탐색 자동화 업체 타이니피시(TinyFish)는 실제 웹 탐색 작업 50건 중 머큐리 3가 50%를 완료했다고 밝혔다. 옥텐 AI(Octen AI)는 스마트 안경 기반 검색에서 생성 시간의 중앙값이 0.9초, 전체 응답 시간은 2.2초였다고 전했다. 리비전두조(RevisionDojo)는 학습용 힌트와 답안 표시 기능을 약 1초 만에 제공한다고 설명했다.
이 모델은 인셉션 API 플랫폼과 오픈라우터, 베이스텐, 버셀 등을 통해 이용할 수 있다. 오픈AI API와 호환돼 기존 개발 환경에 비교적 쉽게 통합할 수 있으며, 최대 100만 토큰의 문맥 길이를 지원한다.
정식 가격은 입력 토큰 100만 개당 0.20달러, 출력 토큰 100만 개당 0.70달러다. 출시 기념으로 입력은 0.10달러, 출력은 0.35달러에 제공한다. 캐시된 입력 토큰에는 입력 가격의 90% 할인을 적용한다. 기업 고객은 전용 처리 용량과 자동 확장, 데이터 보존 설정 등의 추가 기능도 이용할 수 있다.
인셉션은 음성 AI의 첫 응답 지연을 줄이는 ‘머큐리 보이스(Mercury Voice)’와 대량 분류 작업에 특화된 의사결정 모델 ‘머큐리 디사이드(Mercury Decide)’도 함께 선보이며 실시간 AI 제품군을 넓히고 있다.