리퀴드 AI가 기업과 개인이 직접 관리하는 기기에서 AI 에이전트와 음성 비서, 이미지·영상 인식 기능을 실행할 수 있는 새 AI 모델 제품군 ‘LFM3’를 공개했다. 20억 개 매개변수 규모의 소형 모델 6종으로 구성됐으며, 기기에서 빠르게 실행하면서 브라우저 자동화와 업무용 애플리케이션 제어 같은 복잡한 작업을 수행하도록 설계됐다.
리퀴드 AI는 27일(현지시간) LFM3를 발표하며 텍스트, 이미지, 음성, 멀티모달, 의사결정 모델을 하나의 공통 기반 아키텍처로 통합했다고 밝혔다.
모델 가중치는 허깅페이스와 리퀴드 AI 플레이그라운드, API를 통해 제공된다. 기업은 자체 데이터로 모델을 미세조정한 뒤 기기나 사내 서버, 클라우드 환경에 배포할 수 있다.
제품군은 텍스트 모델 ‘LFM3-1.7B’, 시각 모델 ‘LFM3-VL-2B’, 오디오 모델 ‘LFM3-오디오-2B’, 멀티모달 모델 ‘LFM3-옴니-2B’, 의사결정 모델 ‘d1-2B’와 ‘d1-옴니-2B’ 등 총 6종이다.
매개변수 규모는 약 17억~22억 개다. 대형 범용 모델 하나를 사용하는 대신 필요한 기능에 맞는 소형 모델을 선택할 수 있도록 했다. 특히 표준 트랜스포머 아키텍처 대신 고유의 하이브리드 선형 대수 및 신경망 기반 아키텍처를 도입해 효율성을 높였다.
이번 제품군의 핵심은 기업이 직접 관리하는 기기에서 AI 에이전트를 실행할 수 있다는 점이다. 텍스트 모델은 이메일 분류와 일정 관리, 웹 검색, 업무용 애플리케이션 조작 등을 지원한다.
리퀴드 AI는 헤르메스 에이전트, 파이(Pi), 오픈클로 등 에이전트 프레임워크에서 활용할 수 있도록 모델을 학습했다고 설명했다. 개발자들이 로컬 환경에서 모델을 시험할 수 있도록 지원 체계도 확대했다.
브라우저와 업무용 소프트웨어를 다루는 일부 평가에서는 더 큰 모델보다 좋은 결과를 냈다. LFM3-1.7B는 브라우저 자동화 평가인 ‘웹아레나-검증(WebArena-Verified)’과 업무 자동화 평가인 ‘오토메이션벤치(AutomationBench)’에서 큐원3.5-9B보다 높은 점수를 기록했다. 다만 코딩과 일반 지식 등 일부 분야에서는 더 큰 모델이 앞선다고 밝혔다.
LFM3는 기존 LFM2 계열의 효율적인 구조를 발전시킨 하이브리드 아키텍처를 적용했다. 짧은 합성곱 연산과 제한된 범위의 어텐션, 전체 문맥을 처리하는 어텐션을 조합해 연산량을 줄이면서 긴 입력도 다룰 수 있도록 했다. 사전 학습에는 22조 개 토큰을 사용했으며, 텍스트 모델의 문맥 길이는 최대 25만6000토큰이다.
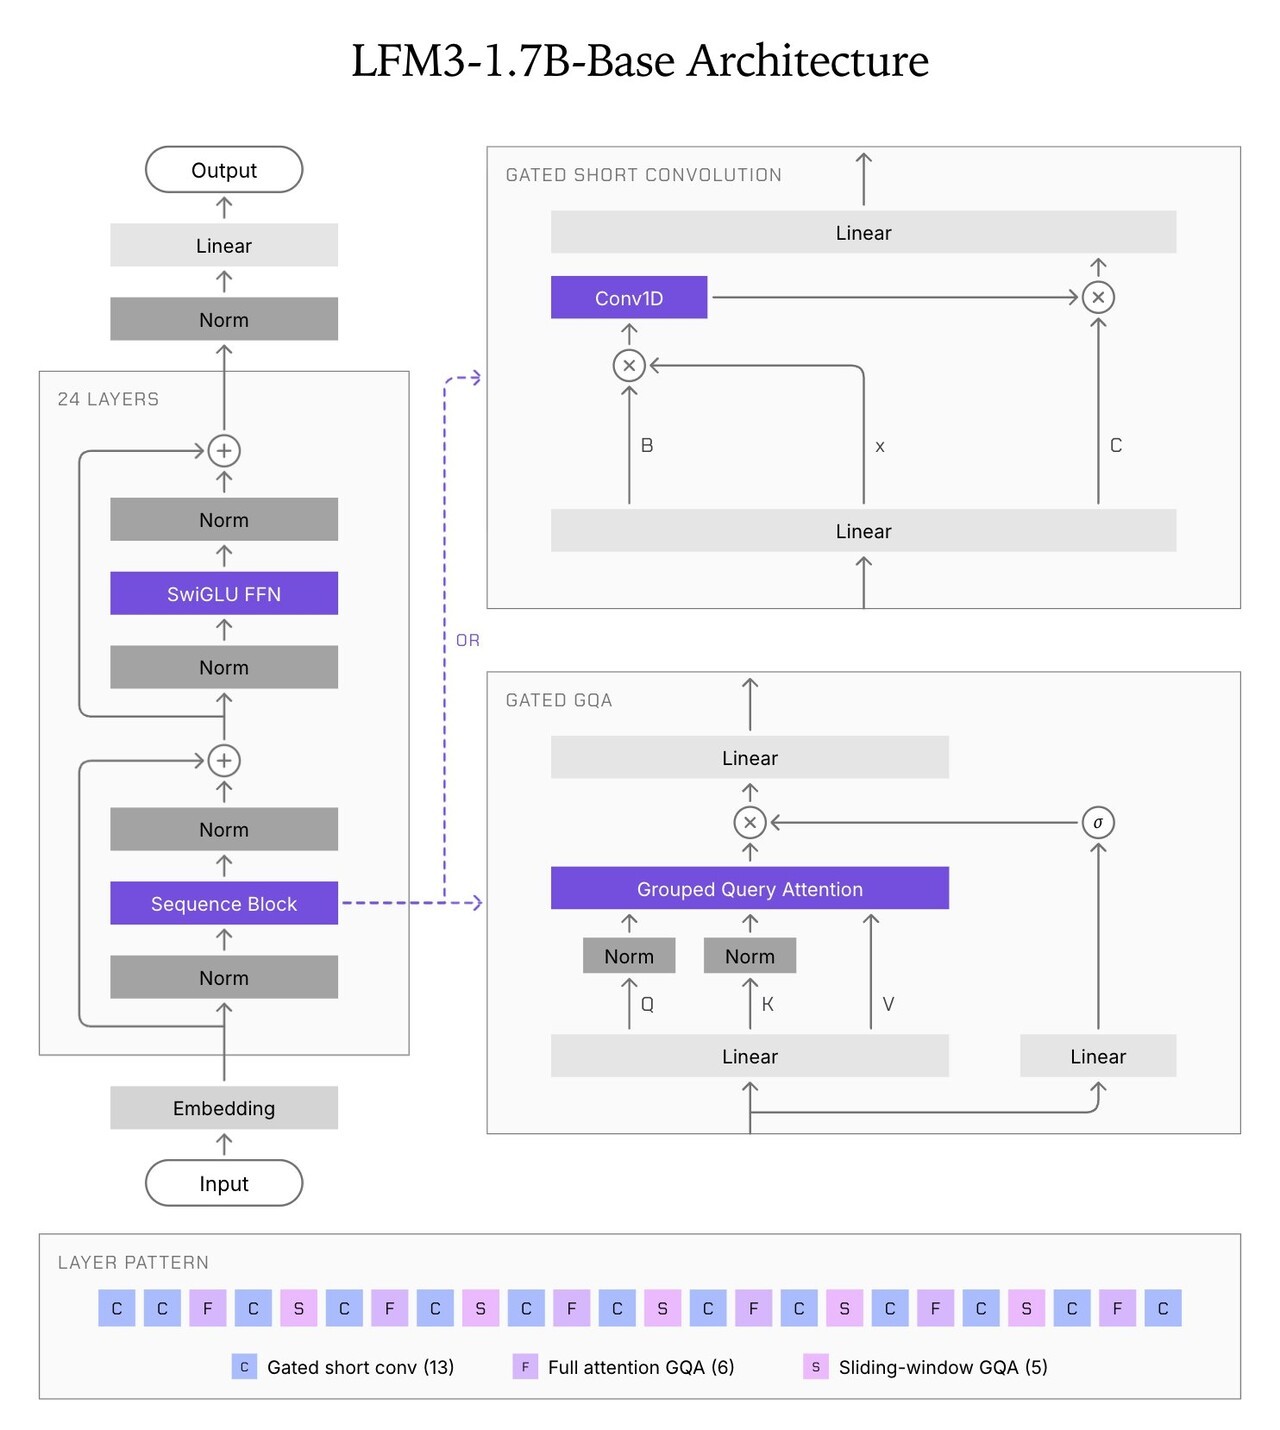
리퀴드 AI는 LFM3-1.7B가 기기 내 추론 속도에서도 경쟁력을 보였다고 밝혔다. 자체 측정 결과 세 종류의 기기 모두에서 비교 대상 모델보다 토큰을 빠르게 생성했고, 후속 모델보다 1.8~2.8배 높은 속도를 기록했다. 12만8000토큰의 문맥을 처리할 때 필요한 키·값(KV) 캐시 메모리는 1.6GB다. 이는 비교 대상인 큐원3.5-4B의 4.3GB와 MiniCPM5-2B의 5.6GB보다 적은 용량이다.
시각 모델 LFM3-VL-2B는 이미지뿐 아니라 영상도 입력으로 처리한다. 녹화한 강의나 스마트폰으로 촬영한 현장 영상, 카메라 피드에 관해 질문하고 답변을 받을 수 있다. 사물의 위치와 공간적 관계를 파악하는 기능도 있어 문서 분석, 산업 현장 검사, 로봇 제어 등으로 활용 범위를 넓힐 수 있다.
오디오 모델 LFM3-오디오-2B는 음성을 텍스트로 변환하고 음성으로 답변하는 한편, 녹음된 소리와 사건을 해석할 수 있다. 18개 언어의 음성 인식·생성·번역을 지원하며, 음성 명령을 소프트웨어 도구 호출로 연결하는 기능도 제공한다. 리퀴드 AI는 입력 음성이 끝나기 전부터 처리를 시작해 첫 토큰 생성까지 걸리는 시간을 최저 50밀리초(ms)로 단축했다고 밝혔다.
LFM3-옴니-2B는 시각·음성·언어 기능을 하나로 결합한 모델이다. 사용자가 이미지나 주변 환경을 보면서 음성으로 질문하면 텍스트나 음성으로 답변할 수 있으며, 영상과 소리를 함께 분석해 상황을 파악할 수도 있다. 시각 정보와 음성 지시를 결합해 앱이나 디지털 인터페이스를 제어하는 작업도 지원한다.
새 의사결정 모델 2종은 자연어 답변을 길게 생성하기보다 입력을 분석해 구조화된 결과를 내는 데 초점을 뒀다. 문서에서 특정 숫자나 날짜를 추출하거나 이미지 속 사물의 위치를 표시하고, 여러 선택지 중 해당 항목을 고르는 작업을 한 번의 처리 과정으로 수행한다. 음성을 입력받는 d1-옴니-2B는 통화나 음성 메모를 분류하고 후속 작업으로 이어가는 데 활용할 수 있다.
기업 데이터에 맞춰 모델을 특화하는 방법도 제시했다. 풍력 터빈 블레이드 사진 3000장으로 LFM3-VL-2B를 미세조정한 다음, 별도의 이미지 약 1400장으로 평가했다. 결함 분류 정확도는 미세조정 전 10% 미만에서 67%로 상승했다고 밝혔다. 다만 결함 위치까지 찾아내는 탐지 F1 점수는 0.11에 그쳐 실제 산업 현장에 적용하려면 추가 검증이 필요하다.
리퀴드 AI는 클라우드에만 의존하지 않고 다양한 기기에서 AI를 실행할 수 있다는 점을 강조했다. “LFM3는 특화된 지능을 위해 설계됐다”며 “모델을 자체 데이터로 미세조정하고 애플리케이션이 실행되는 기기에서 직접 운용할 수 있다”고 설명했다.