딥시크가 적은 비용으로 긴 문맥을 처리할 때 쓰는 메모리 절약 기술에서 성능 저하 문제가 확인됐다. 입력 정보를 압축할 때 문서 안에서 정보가 놓인 위치에 따라 검색 정확도가 크게 달라질 수 있다는 연구 결과다. 평균 벤치마크 점수가 높아도 특정 위치의 정보를 제대로 찾지 못할 수 있다는 지적이다.
바이트댄스와 프린스턴대학교, 스탠퍼드대학교, UC 버클리 연구진은 최근 연구 논문 ‘주기적 약점: 청크형 KV 캐시 압축으로 인한 위상 민감도(Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression)’를 온라인 아카이브에 공개했다.
연구진에 따르면 ‘딥시크-V4’와 ‘V4.1’을 포함해 자체 사전 학습한 모든 압축 모델에서 같은 성능 저하 현상이 나타났다.
연구의 핵심은 청크형(chunked) ‘KV 캐시’ 압축 방식이 정보가 놓인 위치에 따라 서로 다른 검색 결과를 낳을 수 있다는 점이다. KV 캐시는 AI 모델이 입력 문맥을 처리하며 만든 정보를 저장하는 메모리 영역이다. 입력이 길어질수록 메모리 사용량과 연산 비용이 늘어나므로, 딥시크는 연속된 토큰을 일정한 단위로 묶어 캐시 항목 수를 줄이는 방식으로 압축한다.
문제는 이 압축 단계에서 생긴다. 모델은 어떤 정보를 나중에 다시 요청받을지 미리 알 수 없으므로, 압축한 요약에 필요한 정보를 남겨야 한다. 하지만 입력 내용이 같아도 압축 구간의 경계에서 정보가 차지하는 위치에 따라 압축 결과가 달라질 수 있다. 연구진은 위치에 따라 검색 성능이 주기적으로 달라지는 이 현상을 ‘위상 민감도(phase sensitivity)’라고 정의했다.
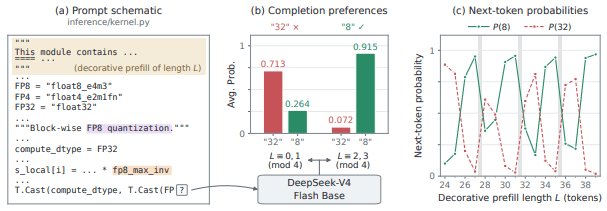
연구진은 12만8000토큰 분량의 입력으로 딥시크 모델의 정보 검색 능력을 평가했다. 딥시크 V4 계열 모델에 특정 정보를 넣은 뒤 위치만 바꿔 검색 정확도를 비교한 결과, 기본 모델은 위치에 따라 검색 정확도가 최대 40.2%포인트 차이 났다. ‘딥시크-V4 플래시’ 기본 모델의 격차는 40.2%포인트였고, V4 프로 기본 모델은 34.8%포인트였다.
추가 학습을 거친 모델에서는 격차가 줄었지만 완전히 해소되지는 않았다. 딥시크 V4 플래시는 19.1%포인트, ‘V4 프로’는 14.8%포인트의 차이를 보였다. ‘V4.1 플래시’의 격차는 6.1%포인트로 비교적 작았지만, 정보 위치에 따른 차이는 여전히 관찰됐다.
연구진은 딥시크 모델 외에도 압축 기술을 적용해 자체 학습한 여러 모델에서 같은 패턴을 확인했다. 반면 일반적인 전체 어텐션을 사용하는 비교 모델에서는 이런 주기적 성능 변화가 나타나지 않았다. 이는 청크형 압축 방식이 문제의 주된 원인일 가능성을 뒷받침한다.
이번 연구는 평균 정확도만으로 모델의 실제 성능을 충분히 가늠하기 어렵다는 점도 보여준다. 종합 점수가 높더라도 특정 위치에 놓인 정보는 거듭 놓칠 수 있기 때문이다. 연구진은 “높은 평균 정확도가 위치별 실패와 공존할 수 있다”며 압축 구간 안에서 정보의 위치를 바꿔가며 성능을 측정해야 한다고 강조했다.
KV 캐시 압축은 긴 문맥을 효율적으로 처리할 수 있다는 장점이 있지만, 입력 정보의 위치에 따라 성능이 주기적으로 흔들리는 근본적인 한계가 있다. 그동안 AI 업계가 전체 평균 벤치마크 점수나 전체 토큰 수를 내세우는 데 집중하면서, 세부 작업 환경에서 생기는 이런 위치별 취약점은 이제야 드러나게 됐다.
다만 이번 결과가 딥시크 모델을 실제로 사용하는 모든 환경에서 같은 수준의 문제가 발생한다는 의미는 아니다. 연구진은 통제된 정보 검색 실험과 코드 자동 완성 사례에서 위치에 따른 오류를 확인했지만, 이 현상이 실제 응용 환경의 안전성과 신뢰성에 미치는 영향은 추가 연구가 필요하다고 밝혔다.