마이크로소프트(MS)가 매개변수 2조8000억개 규모의 대규모 AI 모델 ‘MAI-베이스-2(MAI-Base-2)’의 사전 학습을 완료했다고 밝혔다. 정식 출시를 앞두고 무스타파 술레이먼 MS AI CEO까지 개발 성과를 직접 강조했다. 오픈AI 등 외부 모델에 대한 의존을 낮출 수 있는 자체 개발 역량을 부각하려는 움직임으로 해석된다.
MS는 15일(현지시간) 자체 개발 모델 ‘MAI-베이스-2’의 사전 학습을 마쳤다고 발표했다.
이 모델은 매개변수 2조8000억개로 구성된 MoE 기반 모델이다. 토큰 하나를 처리할 때 활성화되는 매개변수는 800억개다.
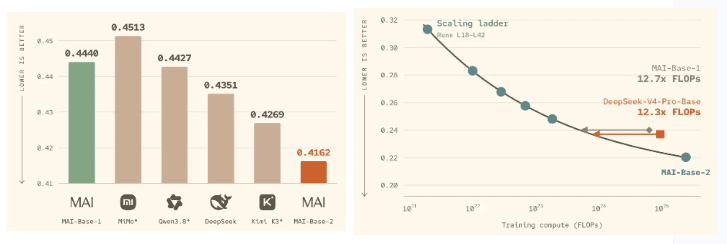
MS는 자체 평가에서 비교 대상으로 삼은 모든 오픈웨이트 모델보다 높은 성능을 냈다고 밝혔다. 학습에 포함되지 않은 텍스트와 코드 등의 다음 내용을 얼마나 정확하게 예측하는지 측정하는 방식으로 평가했다.
또 사전 학습에 필요한 부동소수점 연산량(FLOPs)을 기준으로 딥시크의 ‘V4 프로 베이스(DeepSeek-V4-Pro-Base)’보다 4.2~12.3배 높은 효율을 달성했다고 설명했다. 이 수치는 딥시크 모델과 같은 평가 수준에 도달하는 데 필요한 연산량을 추정해 산출했다.
MAI-베이스-2의 실제 총학습 연산량은 비교 모델인 딥시크 모델보다 컸다. MS는 효율을 높여 절감한 연산 자원을 더 큰 모델을 학습하는 데 사용했다고 밝혔다. 올해 6월 공개된 MAI-베이스-1과 견주면 연산 효율은 6.3~12.7배 개선됐다.
이번 모델은 엔비디아 ‘GB200’ GPU 1만6000개를 동원해 2026년 8~9월 38일 동안 학습했다. 학습 데이터도 MAI-베이스-1보다 늘었다. 중복을 제외한 고유 토큰 기준으로 약 36% 증가했다. MS는 데이터 처리와 모델 구조, 학습 인프라를 함께 개선해 성능과 효율을 끌어올렸다고 설명했다.
모델 구조에서는 모든 계층에 MoE를 적용했다. 이전 모델은 메모리와 연산 효율 문제로 MoE 계층과 일반 계층을 번갈아 배치했다. 이번에는 전문가 간 작업량 차이로 생기는 메모리 낭비와 처리 지연을 낮추는 기술을 도입했다. 그 결과 MoE 계층의 모델 연산 활용률을 24%에서 35%로 높였다고 밝혔다.
최적화 알고리즘도 손봤다. 대규모 모델 학습의 안정성과 효율을 높이기 위해 ‘뮤온(Muon)’ 옵티마이저를 적용하고, 활성값의 기울기를 제한하는 기법을 함께 사용했다. 비정상적인 기울기가 전체 학습에 미치는 영향을 줄여 학습을 안정화했다는 설명이다.
데이터와 관련해서는 다른 AI 모델의 출력을 따라 배우는 증류 학습 대신, 직접 수집하고 처리한 데이터를 활용했다고 강조했다. MS는 “최첨단 성능을 달성하는 기반은 다른 모델의 증류가 아닌 자체 데이터”라며 학습에 쓰인 모든 토큰을 내부에서 처리했다고 밝혔다.
이 모델은 이미지와 텍스트를 처음부터 함께 학습하도록 설계됐다. 학습 데이터에는 이미지 설명, 차트 이해, 시각적 객체 위치 파악, 공간 추론, 의료 정보 분석, 컴퓨터 사용 등 여러 작업이 담겼다. 시각언어모델(VLM) 데이터는 반복 학습까지 포함한 전체 50조 토큰 학습 구성의 18%를 차지했다.
MS는 MAI-베이스-2를 차세대 자체 모델의 토대로 삼아 자사 제품에 먼저 적용한 뒤, 기업 고객으로 공급을 넓힐 계획이다. 자체 모델 개발부터 데이터 관리와 학습 인프라까지 전 과정을 통제해 성능과 비용을 함께 최적화하고, 신뢰할 수 있는 파트너에게 모델 가중치도 제공한다는 방침이다. 가중치는 MS의 AI 플랫폼 ‘파운드리(Foundry)’를 통해 공급할 예정이다.
MAI-베이스-2는 현재 사후 학습 단계에 있다. MS는 향후 추가 평가 결과를 공개할 계획이며, 후속 모델 MAI-베이스-3의 개발 준비도 이미 시작했다고 밝혔다.
이번 발표에서 눈에 띄는 대목은 사용자에게 제공할 제품이 완성되기 전에 사전 학습 성과를 먼저 공개했다는 점이다. 다른 모델을 가져와 서비스를 만들거나 추가 학습하는 수준을 넘어, 대규모 기반 모델을 처음부터 직접 개발할 수 있다는 점을 강조한 것으로 풀이된다.
술레이먼 CEO가 내부에서 한 발언에서는 경쟁 의식이 더 뚜렷하게 나타났다. 비즈니스인사이더 보도에 따르면, 그는 이날 직원 대상 타운홀에서 GPT-5.6 솔의 기반 모델보다 강한 사전 학습 모델을 오픈AI가 사용한 연산량의 약 4분의 1만으로 만들었다고 주장했다. 다만 오픈AI와의 비교는 비공개 평가에 근거한 것으로, 이를 검증할 상세 결과는 공개 기술 보고서에 담기지 않았다.
업계에서는 이번 발표를 MS의 자체 모델 확보 전략과 연결해 바라봤다. 외부 공급자 의존도를 낮추기 위한 또 하나의 진전이라는 평가도 나왔다. 오픈AI 모델을 공급받는 주요 파트너인 MS가 자체 모델의 성능과 학습 효율을 함께 내세워 모델 공급자로서의 경쟁력도 부각하고 있다는 것이다.
자체 데이터와 모델 가중치 공급 계획을 함께 강조한 것도 같은 흐름으로 볼 수 있다. 기업 고객에게 모델 성능뿐 아니라 학습 데이터의 출처를 관리하고 모델과 인프라를 함께 조정할 수 있다는 점까지 제시한 셈이다. 보고서 마지막에 차세대 모델 개발을 위한 채용 안내를 실은 것은 연구 인력을 확보하려는 의도로 해석됐다.
그러나 사전 학습 평가에서 앞섰다고 해서 완성된 서비스의 성능까지 입증된 것은 아니다. 실제 활용 능력을 좌우하는 추론과 지시 수행 등을 다듬는 사후 학습이 진행 중이기 때문이다. 따라서 이번 공개는 최종 제품의 경쟁력을 증명했다기보다, MS가 첨단 모델을 독자적으로 개발할 기반을 갖췄다는 점을 먼저 알린 것으로 볼 수 있다.