오픈AI의 ‘GPT-6 아스트라’가 미공개 이론물리학 연구 문제 50개 가운데 49개를 사람의 도움 없이 풀었다. 관련 문헌을 검색하고 계산식을 세운 뒤 코드를 실행하는 과정까지 자율적으로 진행했다. 채점 중에는 전문가가 작성한 기준 답안의 오류도 찾아냈다.
인도 국제이론과학센터(ICTS), 타타 기초과학연구소, 펜실베이니아대학교, 구글 딥마인드 등의 연구자 35명은 지난 9일 아카이브에 이론물리 평가 벤치마크 ‘시오피즈이밸(TheoPhysEval)’과 이를 이용한 평가 결과를 담은 논문을 공개했다.
이 벤치마크는 AI 에이전트가 실제 이론물리 연구에서 요구되는 문제를 얼마나 독립적으로 해결하는지 평가하기 위해 개발됐다. 연구진은 모델에 검색 및 코드 실행 도구를 제공하고, 문제를 받은 뒤 최종 답을 구하는 능력을 측정했다.
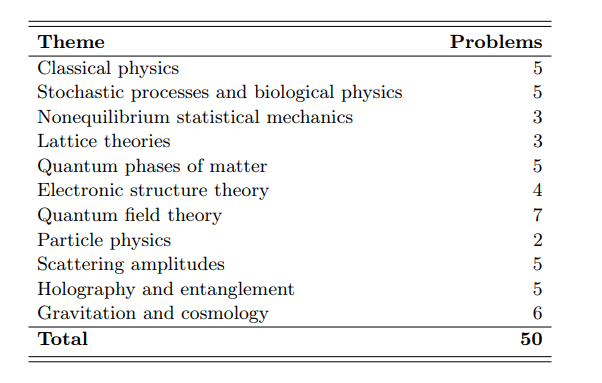
문제는 고전물리학, 양자장론, 입자물리학, 중력·우주론 등 11개 분야에서 출제됐다. 기존 연구의 조건을 변경해 새로운 결과를 계산하는 과제도 들어 있다. 한 예로 5차원 시공간의 블랙 스트링 연구를 찾아본 다음, 조건을 4차원으로 바꿔 수치 계산을 수행하게 했다. 알려진 답을 검색하는 것만으로는 풀 수 없고, 기존 계산 내용을 이해해 수정해야 하는 문제다.
다만 물리학의 주요 미해결 난제는 시험에서 제외했다. 연구진은 각 분야 전문가가 보통 하루 안에 풀 수 있는 난도라고 설명했다.
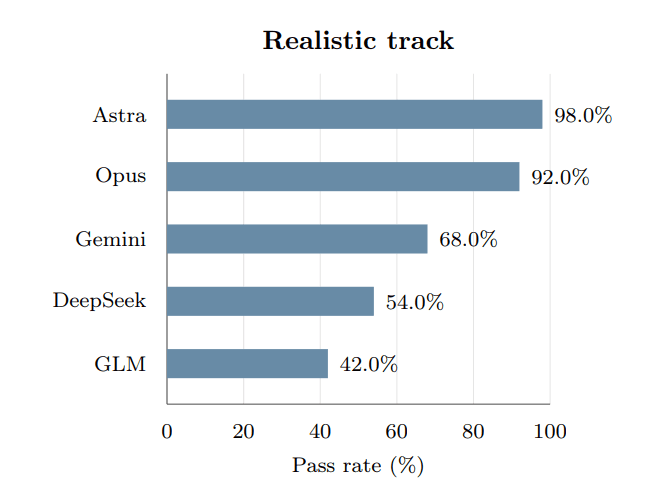
이번 평가에는 AI 모델 5개가 참여했다. 웹 검색과 코드 실행이 허용된 환경에서 GPT-6 아스트라는 50개 문제 중 49개를 맞혔다. API 이용 비용은 모두 116.28달러였고, 문제당 평균 비용은 약 2.33달러였다.
‘오퍼스 5.5’는 46개를 풀어 뒤를 이었다. ‘제미나이 3.8 플래시’는 34개를 해결했고, 오픈 모델인 ‘딥시크-V4.1 플래시’와 ‘GLM-5.3’은 각각 27개와 21개를 맞혔다. 인터넷을 사용할 수 없도록 한 조건에서는 아스트라와 오퍼스 5.5가 각각 46개를 해결했다.
아스트라가 풀지 못한 유일한 문제는 주어진 곡선에서 출발해 그 곡선을 만들어내는 미분방정식을 역으로 찾아야 하는 과제였다. 다른 모델들 역시 이 문제를 해결하지 못했다.
공동 저자인 ICTS 연구원 수브랏 라주는 14일 개인 블로그에 평가가 시작된 배경을 소개했다. 약 6개월 전 자신이 공개하지 않은 문제를 AI에 냈을 때 처음에는 오답이 나왔지만, 몇 차례 힌트를 제공하자 문제를 풀었다고 한다.
그 뒤 전문가들로부터 문제를 모으는 사이 새 모델의 성능이 빠르게 향상됐다. 연구진은 출제자들에게 문제 난도를 계속 높여 달라고 요청했다.
라주는 “솔직히 이런 날이 이렇게 빨리 올 줄은 예상하지 못했다”며 “결과를 확인한 뒤 며칠 밤 제대로 잠들 수 없었다”고 밝혔다.
그가 특히 강조한 부분은 서로 다른 전문 분야를 넘나드는 능력이었다. 자신이 낸 문제는 풀 수 있어도 다른 분야 문제 상당수는 무슨 뜻인지조차 이해하기 어렵다는 설명이다.
채점 중에는 뜻밖의 상황도 벌어졌다. 라주에 따르면 아스트라의 최초 점수는 80점대 후반이었다. 하지만 오답 판정을 받은 답을 다시 살펴보자, 아스트라는 자신의 풀이가 옳으며 전문가의 답안에 오류가 있다고 주장했다.
연구진은 해당 문제를 출제자들에게 재검토해 달라고 요청했고, 여러 계산에서 미세한 오류를 발견했다. 전문가들이 답안을 고친 뒤 아스트라의 최종 정답률은 98%로 높아졌다.
경제학자 알렉스 타바록도 이 대목을 언급했다. 그는 15일 블로그 ‘한계혁명’에서 인간이 만든 정답으로 AI를 평가하려던 시험이, 결과적으로 AI의 답을 이용해 전문가의 계산을 검증하는 상황으로 바뀌었다고 평했다.
연구진은 이번 결과가 초기 연구자 교육에도 변화를 가져올 수 있다고 봤다. 이런 과제는 대학원생이 기존 연구를 배우고 첫 결과를 얻는 데 사용돼 왔다. AI가 답을 도출할 수 있게 된 만큼, 과제를 낼 때 계산 과정을 익히는 것이 목표인지 명확히 할 필요가 있다는 것이다.
이번 평가에는 몇 가지 한계가 있다. 각 에이전트는 최종 답을 기준으로 한 번씩만 평가받았고, 일부 출제자는 문제를 푸는 과정에서 AI 도구를 사용했다. 연구진은 그에 따라 평가 문제나 정답이 사전에 모델에 노출됐을 가능성을 완전히 배제할 수 없다고 밝혔다.
저자들은 이번 결과가 AI 에이전트가 이론물리 연구에 필요한 구체적인 계산을 높은 정확도로 수행할 수 있다는 점을 보여준다고 설명했다.
그러나 현재 에이전트는 연구 가치가 있는 문제를 선별하거나, 풀기 어려운 과제를 만났을 때 다른 유망한 문제로 방향을 전환하는 능력이 부족하다고 지적했다. 맡길 수 있는 계산의 범위는 넓어졌지만, 연구 방향을 정하거나 새 이론을 만들어내는 역량까지 증명된 것은 아니라는 뜻이다.