AI의 내부 작동을 이해하는 데 걸림돌이 되는 장벽이 생각보다 낮을 수 있다는 주장이 나와 논쟁을 불러일으켰다. 신경망 안에 서로 관련 없는 개념이 뒤섞여 있다는 기존 해석을 연구자가 직접 뒤집은 것이다. 이 주장이 AI 안전성 연구의 흐름을 바꿀 획기적인 전환인지, 아니면 제한적인 진전에 그치는지를 두고 전문가들의 의견이 갈리고 있다.
비즈니스인사이더 등에 따르면, 전 오픈AI 연구원 닉 카마라타가 15일(현지시간) 공개한 에세이 ‘신경망은 이미 정돈돼 있다(Neural Networks Are Already Clean)’가 AI 업계 일부에서 주목받고 있다.
AI 해석가능성 기업 굿파이어(Goodfire)의 카마라타는 크리스 올라 등과 함께 ‘줌 인(2020)’과 ‘멀티모달 뉴런(2021)’을 공동 집필한 해석가능성 연구 초기 참여자다. 오픈AI에서는 2023년 AI를 활용해 다른 AI의 뉴런을 설명하는 자동 해석 연구를 시작했다. 이번 에세이에서는 자신이 참여했던 연구의 대표 사례를 다시 살펴보고, 기존 해석에 오류가 있었다고 주장했다.
그의 핵심 주장은 AI 내부가 혼란스럽게 뒤엉킨 것이 아니라, 사람들이 그 안의 공통 원리를 알아차리지 못했다는 것이다.
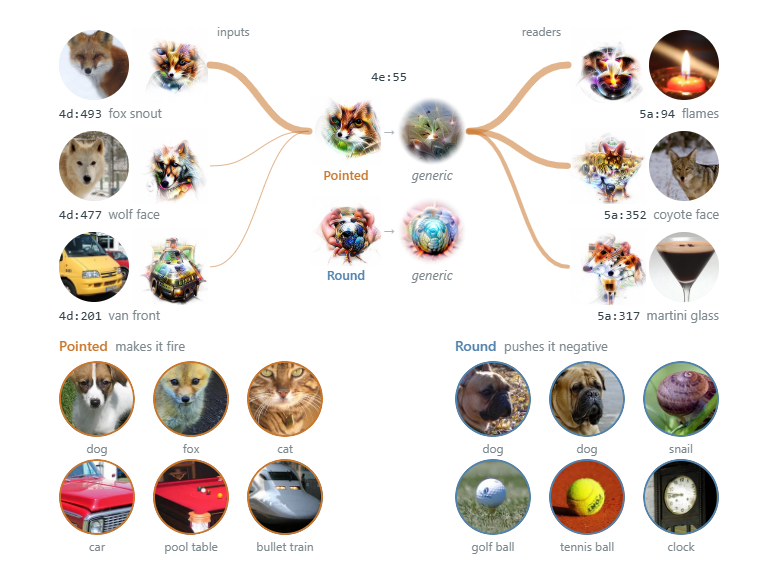
대표 사례로는 고양이 얼굴과 자동차 앞부분에 모두 반응하는 이미지 모델의 뉴런을 들었다. 과거에는 서로 관계없는 두 개념이 하나의 뉴런에 섞여 있다고 봤다. 하지만 카마라타는 이 뉴런이 두 대상에 공통으로 나타나는 뾰족한 V자 형태를 감지한다고 설명했다. 여우 얼굴과 불꽃에도 연결되고, 둥근 형태에는 반대 방향으로 반응한다는 점도 이 해석을 뒷받침한다고 밝혔다.
언어 모델 ‘큐원3-32B(Qwen3-32B)’에서도 뉴런이 양의 값이나 음의 값으로 반응하는 사례를 각각 예비 분석했다. 그 결과 분석 대상의 약 90%가 주된 기능 하나를 수행하는 것으로 추정했다. 다만 분류 기준 등에 따라 이 비율은 달라질 수 있다고 덧붙였다.
연구진은 설명이 그럴듯한지 검토하는 데 그치지 않고, 설명을 바탕으로 뉴런 반응을 예측하는 실험도 했다. 한 AI 에이전트가 뉴런을 살펴 설명을 작성하면, 해당 뉴런을 보지 못한 다른 에이전트가 설명만 참고해 뉴런을 강하게 활성화할 문장을 만드는 방식이다. 일부 실험에서는 이렇게 생성한 문장이 방대한 데이터에서 찾은 사례보다 더 강한 반응을 이끌어냈다고 밝혔다.
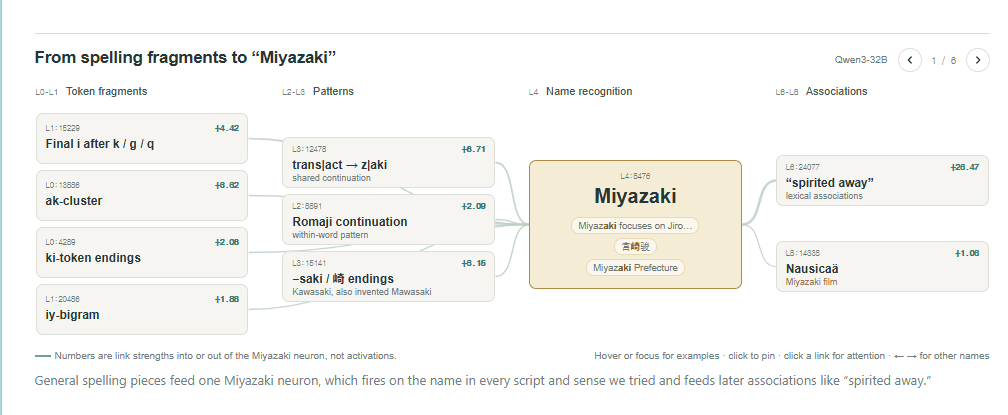
이 주장이 주목받는 이유는 AI를 이해하는 연구 방식에 변화를 가져올 수 있어서다. 뒤섞인 정보를 별도의 모델로 먼저 분리하는 대신, 기존 뉴런과 회로를 직접 살펴보는 접근법을 더 폭넓게 쓸 수 있다. AI 에이전트가 설명을 제시하고 실험을 거듭한다면 분석 규모를 키울 가능성도 있다.
에세이가 공개된 뒤 반응은 나뉘었다. X에서 AI 논평으로 잘 알려진 룬(roon·@tszzl)은 “과학사의 중요한 순간으로 기억될 수 있다”고 평가했다. AI가 인간의 의도에 맞게 행동하도록 하는 정렬 연구를 관찰과 실험을 축적하는 일반적인 과학 연구로 발전시킬 수 있다는 기대도 나왔다.
AI 분석가 앤드류 커런도 비슷한 반응을 보였다. 그는 “초지능이 등장하기 전에 제대로 된 수준의 해석가능성에 도달하는 것은 오래전에 포기했다”며 “너무 낙담해 이 주제에 관한 글을 쓰는 것조차 중단했다”고 밝혔다.
반면 해석가능성 연구자 닐 난다는 AI 안전 커뮤니티 레스롱에 직접 게시한 평가에서 “흥미로운 연구”라고 인정하면서도, 해석가능성 분야의 큰 그림을 바꿀 수준의 진전으로 보지는 않는다고 말했다.
난다는 뉴런을 직접 분석하는 방식이 모델의 의심스러운 행동을 조사하는 등 실용적인 목적에는 유용할 수 있다고 봤다. 그러나 중요한 구성 요소만 골라 회로를 그리는 과정에서 여전히 많은 정보가 빠질 수 있고, 뉴런이 약하게 활성화될 때 담는 정보도 충분히 설명해야 한다고 지적했다. 일부 뉴런이 강하게 반응하는 이유를 이해하는 일과 모델 전체를 빠짐없이 이해하는 일은 다르다는 취지다.
이번 논쟁은 개별 뉴런을 읽을 수 있는지에 그치지 않고, 그 이해를 모델 전체에 얼마나 정확히 확장할 수 있는지라는 본질적인 질문을 제기한다. 카마라타는 기존에 장벽으로 여겨졌던 현상의 상당 부분을 분석 도구의 문제로 해석했지만, 난다는 불완전하고 부분적인 설명만으로 거대한 신경망 전체를 이해했다고 단정하기 어렵다고 본다.
카마라타 역시 이번 글을 확정된 결론이 아닌 ‘작업 가설’로 소개했다. 거대한 언어 모델 전체를 해석한 것은 아니며, 언어 모델 실험의 세부 내용을 담은 기술 논문은 별도로 공개할 예정이라고 밝혔다.