텐센트가 여러 AI 챗봇과 코딩 도구의 메모리를 한곳에 모아 공유하는 오픈소스 기술을 공개했다. AI 서비스마다 별도로 저장되던 대화와 작업 기록을 하나의 저장소에 연결해, 도구를 바꾸더라도 이전 맥락을 이어서 작업할 수 있도록 하는 것이 핵심이다.
텐센트는 16일, 서로 다른 AI 챗봇과 코딩 도구 사이에서 사용자의 대화 내용과 작업 기록을 공유하는 오픈소스 메모리 시스템 ‘하이 메모리 2.0(Hy-Memory 2.0)’을 선보였다.
이 기술은 여러 AI 도구의 기억을 하나로 통합해, 사용자가 다른 서비스로 옮길 때 과거 대화나 프로젝트 진행 상황을 처음부터 다시 설명하는 수고를 덜어준다.
하이 메모리 2.0은 전용 AI 모델, 메모리 관리 프레임워크, 데스크톱 애플리케이션 ‘멤허브(MemHub)’로 이뤄진 3계층 AI 에이전트 메모리 시스템이다. 특정 AI 서비스에 메모리를 묶어두지 않고 별도 저장소에서 관리해, 여러 도구가 필요한 정보를 가져다 쓸 수 있도록 설계됐다. 모델과 프레임워크, 애플리케이션은 각각 따로 사용할 수도 있고 서로 연결해 함께 활용할 수도 있다.
멤허브는 클로드 코드(Claude Code), 커서(Cursor), 코덱스(Codex), 오픈코드(OpenCode), 오픈클로(OpenClaw) 등 10종이 넘는 AI 도구를 오픈소스 에이전트 플러그인으로 연동해 지원한다.
사용자가 권한을 허용하면 각 도구의 이전 대화와 작업 기록을 가져와 하나의 메모리 저장소에 통합하고, 새로 생성되는 기록도 계속 동기화한다. 명령줄 인터페이스(CLI)와 맥용 애플리케이션을 제공하며, 메모리는 로컬 중심으로 관리한다.
예를 들어 커서에서 작업하던 코딩 프로젝트를 코덱스로 옮겨도 앞서 내린 결정, 수정한 코드, 작업 진행 상황을 다시 설명할 필요가 줄어든다. 각 AI 도구에 따로 축적된 작업 이력을 연결해 끊김 없는 작업을 지원하는 방식이다.
프레임워크는 기억을 대화·작업·코드, 세 가지 유형으로 분류해 관리한다. 대화 메모리는 과거 대화와 사용자 선호도 같은 장기 맥락을 기록한다. 작업 메모리에는 과제의 목표와 의사결정, 중간 결과, 재사용할 만한 경험을 담는다. 코드 메모리는 코드 변경 이력과 수정 과정, 설계 배경 등을 추적해 이전 작업의 맥락을 이어준다.
이번 버전에 새로 추가된 작업 메모리와 코드 메모리는 여러 단계로 진행되는 과제를 이어서 수행하는 데 초점을 맞췄다. 작업을 다시 시작할 때 현재 진행 중인 과제를 파악하고, 관련 의사결정과 여전히 유효한 경험, 이전 작업 기록을 검색해 활용한다. 대화 메모리도 흩어진 정보를 시간·장소·인물 등을 기준으로 묶고, 중복되거나 서로 충돌하는 정보를 정리하도록 개선했다. 이렇게 추린 정보를 현재 사용하는 AI 도구에 전달해 불필요하거나 오래된 맥락이 답변에 영향을 줄 가능성을 낮추는 것이 목표다.
개발자가 다른 AI 에이전트와 연결할 수 있도록 프레임워크는 소프트웨어 개발 키트(SDK)로 제공된다. 멤허브와 함께 깃허브 에 공개됐다.
텐센트는 메모리 추출과 통합, 정보 충돌 처리를 위한 전용 모델 ‘하이 메모리 30B A3B(Hy-Memory-30B-A3B)’도 공개했다. 전문가 혼합(MoE) 구조로, 전체 약 300억개 매개변수 가운데 약 30억개를 활성화해 사용한다. 일반적인 대화 생성보다 장기 기억을 선별하고 정리하고, 상충하는 정보를 처리·갱신하는 작업에 특화됐다. 모델 가중치는 허깅페이스 에 공개했다.
텐센트는 메모리를 추출하고 정리하는 전용 모델 ‘하이 메모리 30B A3B(Hy-Memory-30B-A3B)’도 선보였다. 전체 약 300억개의 매개변수 중 약 30억개가 활성화되는 전문가 혼합(MoE) 모델로, 장기 메모리 추출과 상충 정보 처리에 초점을 맞췄다. 모델 가중치는 허깅페이스에 공개했으며, 메모리 프레임워크는 파이썬 패키지로도 제공한다.
성능 평가 결과도 공개했다. 텐센트에 따르면 하이 메모리는 메모리 아레나(MemoryArena), 코드메모리벤치(CodeMemoryBench), SWE-컨텍스트벤치(SWE-ContextBench), 로코모(LoCoMo) 등 4개 벤치마크에서 Mem0, MemOS, EverOS 등 오픈소스 메모리 프레임워크보다 높은 성능을 보였다.
작업 메모리는 여행 계획과 쇼핑 과제를 평가하는 메모리 아레나에서 평균 55.31%를 기록했다. 코드 메모리는 코드메모리벤치에서 질의응답 정확도 64.2%, 과제 해결률 35.6%를 달성했고, SWE-컨텍스트벤치에서는 과제 해결률 28.3%를 나타냈다. 대화 메모리는 로코모에서 정확도 72.6%를 기록했다. 질문당 사용 토큰은 1159개에서 703개로 39.3% 감소했다.
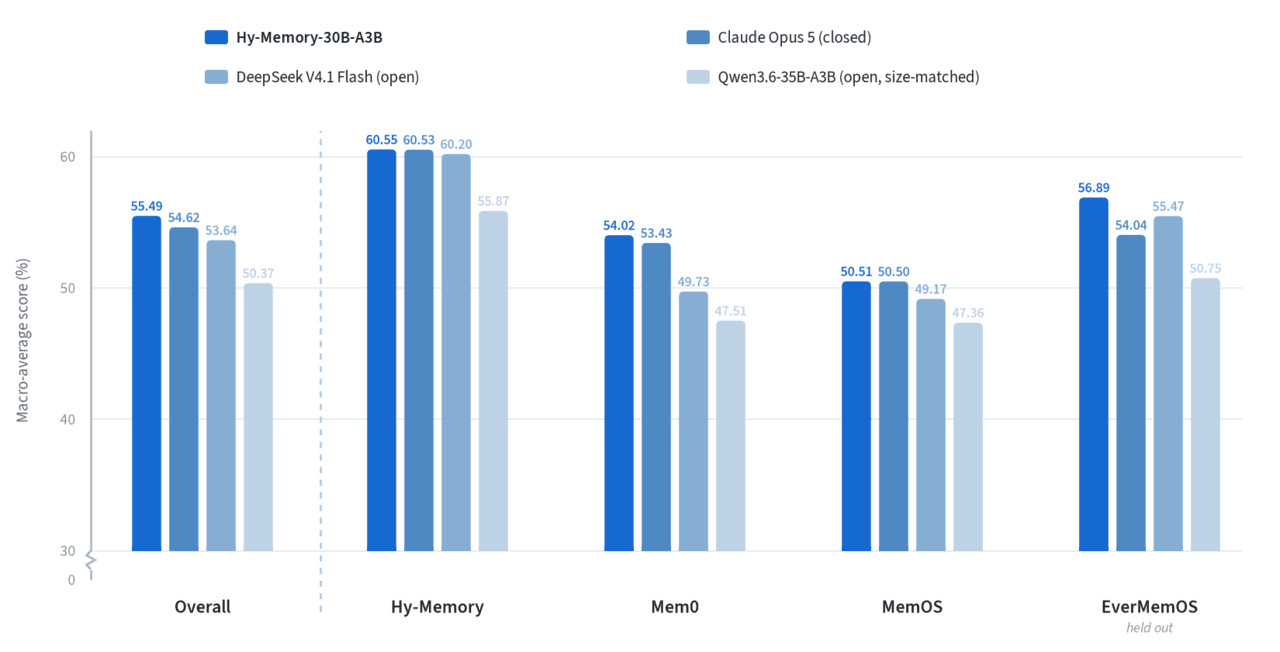
전용 모델 역시 별도 평가에서 경쟁력을 나타냈다. 텐센트가 공개한 기술 보고서에 따르면, 벤치마크 데이터 중 20% 표본을 활용해 장기 기억 추출 및 상충 정보 처리 능력을 평가한 결과, 하이 메모리 모델은 4개 메모리 시스템 대상 매크로 평균 점수 55.49를 기록했다.
이는 '클로드 오퍼스 5'의 54.62와 '딥시크-V4.1 플래시'의 53.64보다 높은 점수다. 다만 이 결과는 제한된 표본과 평가 조건에서 나온 것으로, 실제 환경 전반에서의 범용 성능을 뜻하지는 않는다.