구글이 AI 에이전트의 작업 방식을 스스로 개선하는 오픈소스 프레임워크를 공개했다. 핵심은 AI 모델은 고정한 채, 에이전트가 실제 작업에서 얻은 경험으로 실행 환경을 개선해 결과의 품질을 높이는 것이다.
구글은 모델을 재학습하지 않고도 지시문, 도구 활용법, 메모리, 작업 절차 등을 스스로 개선해 에이전트 성능을 높이는 오픈소스 프레임워크 ‘하네스²(Harness²)’를 최근 온라인 아카이브에 공개했다.
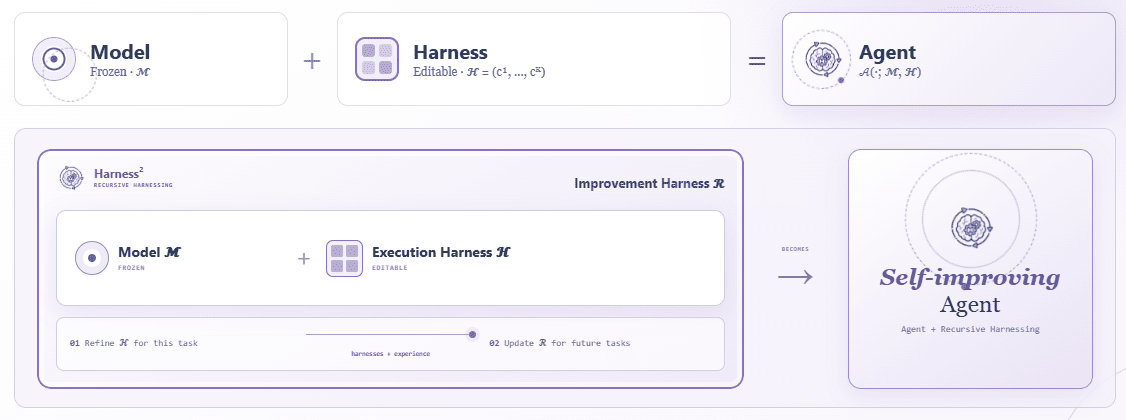
하네스²는 AI 에이전트의 성능이 기반 모델뿐 아니라 모델을 둘러싼 실행 환경에도 좌우된다는 점에 착안했다. 여기서 하네스란 시스템 프롬프트, 가이드라인과 안전 규칙, 메모리, 도구 활용 지침, 하위 에이전트, 스킬, 스크립트, 플러그인·미들웨어 등 파일 형태로 마운트되는 8가지 핵심 컴포넌트를 말한다.
기존에는 AI 성능을 높이기 위해 모델을 재학습하거나 정답이 정해진 평가 데이터를 활용하는 경우가 많았다. 그러나 실제 환경에서는 새로운 작업이 계속 등장하고, 결과의 정오를 자동으로 판정할 기준이 없을 때도 있다. 하네스²는 별도의 정답 검증기가 없는 오픈월드 환경에서 에이전트가 실제 작업 중 보인 행동 양상을 서로 비교하는 대조적 검증 방식(Propose-Probe-Compose)으로 실행 방식을 수정하도록 설계됐다.
핵심은 두 단계로 반복되는 개선 구조다. 첫 번째 단계에서는 현재 작업에 맞게 하네스를 수정한다. 에이전트가 기본 설정으로 작업을 수행하면 개선 시스템이 두 가지 수정안을 제시한다. 하나는 계획 수립이나 도구 사용처럼 여러 작업에 공통으로 적용할 수 있는 문제를 다루고, 다른 하나는 특정 분야의 지식이나 절차를 개선하는 데 초점을 둔다.
그런 다음 두 수정안을 같은 작업에 적용해 결과를 비교한다. 개선 시스템은 실제 작업 과정에서 관찰한 차이를 토대로 효과가 입증된 변경 사항을 선택한다. 별도의 정답 검증기가 없어도 어떤 수정이 더 나은 결과를 냈는지 비교해 개선 방향을 정하는 것이다.
두 번째 단계는 하네스 레벨의 개선이다. 한 작업에서 얻은 경험을 지속적 개선 라이브러리(LESSONS) 등에 기록해 다음 작업에 활용한다. 가령 특정 도구의 사용법이나 작업 순서를 바꿨을 때 성능이 좋아졌다면, 그 경험을 이후 작업의 개선안에 반영한다.
그렇다고 수정된 설정을 매번 그대로 이어 쓰는 것은 아니다. 새 작업은 기본 하네스에서 시작하며, 이전 작업에서 쌓인 경험을 참고해 필요한 개선안을 다시 제안한다. 특정 작업에만 적합한 수정이 다른 상황에서 부작용을 일으킬 가능성을 낮추기 위해서다.
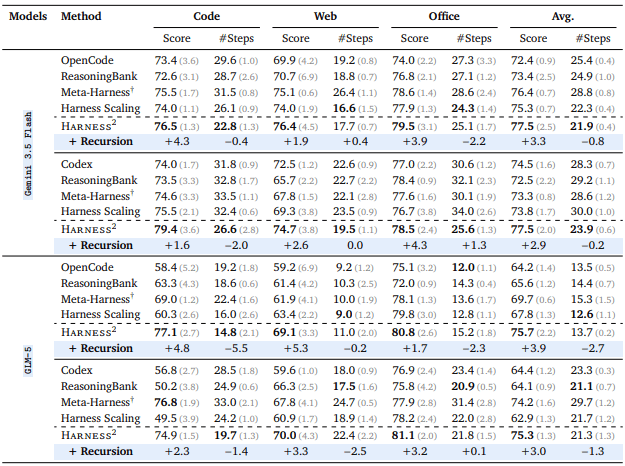
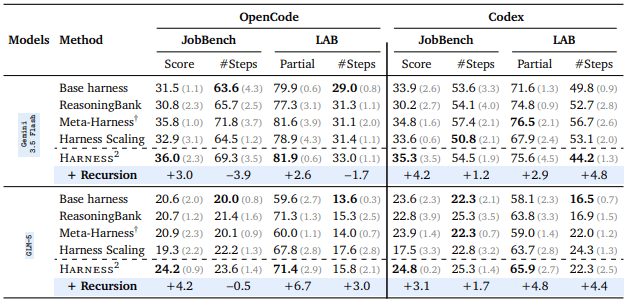
구글 연구진은 전문 업무용 벤치마크 3종인 ‘워크버디 벤치(WorkBuddy-Bench)’, ‘잡벤치(JobBench)’, 하비의 ‘LAB’에서 하네스²를 평가했다. ‘GLM-5’와 ‘제미나이 3.5 플래시’를 기반으로 여러 실행 환경을 조합해 시험한 결과, 한 번의 개선만으로도 네 가지 모델·하네스 구성 모두에서 세 벤치마크의 성능이 올랐다.
가장 큰 향상은 GLM-5를 오픈코드(OpenCode)와 함께 사용했을 때 나타났다. 워크버디 벤치 점수는 64.2점에서 75.7점으로 11.5점 상승했다. 잡벤치에서는 최대 4.5점, 법률 업무 평가인 LAB에서는 평가 항목별 통과율이 최대 11.8%포인트 높아졌다.
개선 폭은 모든 조합에서 동일하지 않았다. GLM-5와 ‘코덱스’를 조합했을 때 잡벤치 점수는 23.6점에서 24.8점으로 1.2점 오르는 데 그쳤다. 연구진은 개선 작업에 더 많은 예산을 투입해 여러 차례 수정안을 탐색하면 성능을 추가로 높일 수 있다고 설명했다.
하네스²는 모델 가중치를 바꾸지 않고 실행 환경만 개선하므로, 모델 재학습에 드는 비용과 부담을 줄일 수 있는 접근법이다. 구글은 이를 깃허브를 통해 오픈소스로 공개해 개발자들이 기존 모델과 에이전트 환경에 적용할 수 있도록 했다.