AI 스타트업 리커시브(Recursive)가 AI 자동화 연구 시스템을 이용해 개발한 오픈소스 온디바이스 코딩 모델 ‘플린트(Flint)’를 선보였다. 소규모 연구팀이 4개월도 채 걸리지 않아 만든 이 모델은 개인 컴퓨터에서 구동할 수 있다. 개발자의 데이터를 안전하게 보관하면서 빠른 코드 생성을 지원한다.
리커시브는 21일(현지시간) 플린트를 공개했으며, 모델 가중치는 허깅페이스에 아파치 2.0 라이선스로 배포했다.
플린트는 총 400억개 매개변수로 이뤄져 있지만, 전문가 혼합(MoE) 구조를 채택해 토큰당 25억개만 활성화한다. 연산량을 낮춰 노트북을 비롯한 로컬 하드웨어에서도 코드를 빠르게 생성하도록 설계됐다.
자체 추론 엔진을 최적화한 결과, 애플 ‘M4 프로’ 칩이 들어간 맥북 프로에서는 초당 125토큰 이상, 엔비디아 ‘RTX 스파크’에서는 초당 150토큰 이상의 생성 속도를 냈다고 리커시브는 밝혔다.
비슷한 코딩 성능을 내는 250억~400억개 매개변수의 밀집형 모델보다 5배 이상 빠르고, 동급 모델과 비교해도 최대 2배 빠르게 작동한다는 설명이다.
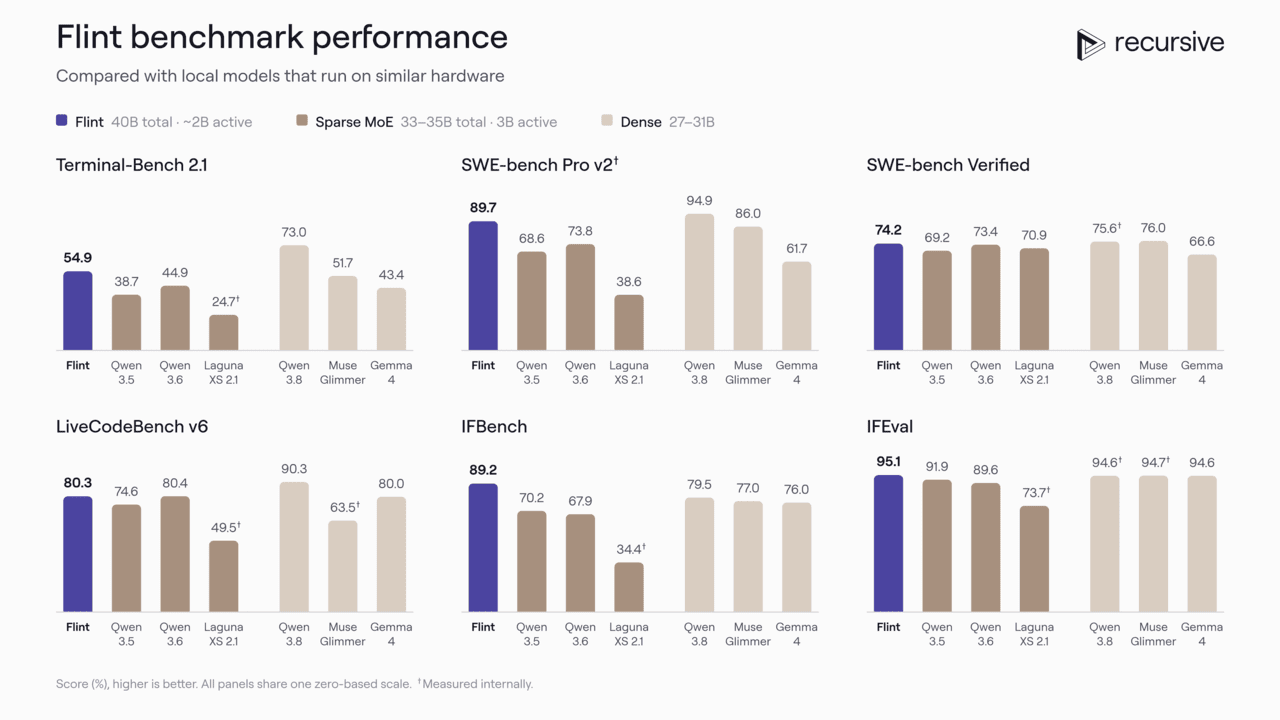
코딩 성능 평가에서도 좋은 결과를 거뒀다. ‘SWE-벤치 프로 v2’, ‘터미널 벤치 2.1’, ‘SWE-벤치 베리파이드’ 등 주요 에이전트 코딩 벤치마크에서 전체 매개변수가 500억개 미만인 MoE 모델 중 가장 높은 성능을 기록했다. 단, 이 결과는 자체 평가에 따른 것이다.
플린트는 모델 성능뿐 아니라 개발 과정에서도 AI를 폭넓게 활용했다. 리커시브는 자동화 연구 시스템 ‘유레카 머신(Eureka Machine)’이 사전 학습 데이터와 학습 방식, 모델 구조를 정하고 추론 인프라를 최적화하는 등 개발 전반을 지원했다고 밝혔다.
유레카 머신은 연구 아이디어를 제시하고, 구현과 실험을 거쳐 결과를 분석한 다음 다음 시도를 정하는 시스템이다. 여러 연구 방향을 동시에 살펴보고 성과가 좋은 아이디어를 결합해 모델을 개선한다. 리커시브에 따르면 이 시스템은 플린트 개발의 거의 모든 단계에 기여했다.
구체적으로 유레카 머신은 토큰마다 활성화되는 매개변수 수를 줄이면서도 성능을 유지할 구조를 탐색했다. 학습을 마친 모델을 저비트로 양자화해 메모리 사용량을 줄이고 정확도 손실을 최소화하는 방법도 찾아냈다. 애플 실리콘과 엔비디아 하드웨어에 맞춘 전용 연산 커널을 개발해 추론 속도 역시 끌어올렸다.
플린트는 최대 51만2000토큰의 컨텍스트 창을 지원하지만, 코딩 작업에는 25만6000토큰 이내로 사용할 것을 권장한다. 개발자는 라마.cpp(llama.cpp), 올라마(Ollama), LM 스튜디오(LM Studio), vLLM 등 여러 도구로 모델을 실행할 수 있다. 리커시브는 애플 M4·M5 프로 및 맥스 칩에 최적화한 경량 추론 엔진 ‘rec’도 함께 공개했다.
로컬에서 실행하면 인터넷 연결 없이 작업할 수 있고, 코드와 데이터를 사용자 기기에 보관하며, 클라우드 API 비용도 피할 수 있다. 다만 플린트 같은 온디바이스 모델을 사용할 때는 클라우드 기반 대형 상용 코딩 모델에 비해 더 구체적으로 지시하거나 작업을 작은 단위로 나눠 전달해야 한다.
리커시브는 메타와 오픈AI 출신 연구원들이 주축이 돼 설립한 AI 스타트업이다. 궁극적으로 AI가 더 뛰어난 AI를 만들고, 그렇게 만들어진 모델이 다시 연구 시스템을 개선하는 ‘재귀적 자기개선(RSI)’을 목표로 하고 있다. 플린트는 이 가능성을 시험하는 첫 모델이다.
이 회사는 새 모델이 등장할수록 유레카 머신의 연구 역량도 강화돼, 후속 모델을 더 빠르고 효율적으로 개발할 수 있을 것으로 기대하고 있다.