AI 코딩 에이전트의 작업 환경을 복잡하게 꾸려도 코드 작성 정확도는 거의 나아지지 않는 반면, 추론 비용은 최대 3배까지 증가할 수 있다는 연구 결과가 나왔다. 모델을 둘러싼 도구와 실행 절차, 즉 ‘하네스’를 정교하게 설계하는 것보다 불필요한 지시문과 도구 정의를 덜어내는 일이 비용 효율에 더 큰 영향을 미칠 수 있다는 분석이다.
중국 산둥대와 미국 UC버클리 연구진은 최근 온라인 아카이브 에 공개한 연구에서 앤트로픽의 ‘클로드 코드’, 오픈소스 도구 ‘오픈코드’, 최소 기능으로 구성된 ‘미니-SWE-에이전트(mini-SWE-agent)’ 등 코딩 에이전트 하네스 3종을 비교·분석했다. 하네스는 AI 모델이 코드를 수정하고 도구를 호출해 작업을 마칠 수 있도록 돕는 실행 환경이다.
연구진은 오픈웨이트 모델인 큐원3.6-35B-A3B와 큐원3.8-27B, API 기반 모델인 딥시크-V4-플래시, GLM-5.3-플래시, HY4-프리뷰를 실험 대상으로 삼았다. 상위권 성능을 비교하기 위한 기준 모델로는 클로드 코드에서 실행한 클로드 오퍼스 5도 포함했다.
평가에는 코드 수정 능력을 측정하는 ‘SWE-벤치 베리파이드’의 오프라인 과제 492개를 사용했다. 사람이 해결하는 데 1~4시간 이상 걸리는 어려운 과제 45개와 나머지 447개를 나누어 살펴봤다.
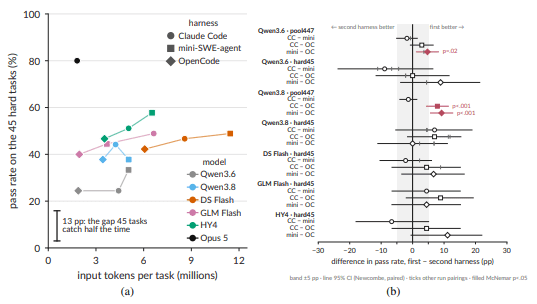
실험에서 기능이 많은 하네스가 경량 하네스보다 일관되게 정확도가 높지는 않았다. 어려운 과제 집합에서는 하네스를 바꿀 때마다 약 13%의 문제가 성공과 실패 사이에서 달라졌다. 하지만 같은 하네스로 실험을 반복했을 때도 비슷한 수준의 결과 변동이 나타났다.
이는 하네스에 따른 성능 차이처럼 보이는 결과 상당수가 실제로는 실행 때마다 생기는 확률적 변동, 즉 노이즈일 수 있다는 뜻이다.
특정 모델 제작사가 자사 모델에 맞춰 만든 하네스라고 해서 성능이 더 좋은 것도 아니었다. 딥시크의 공식 명령줄 하네스를 사용했을 때도 성공률은 다른 하네스들이 기록한 범위 안에 머물렀지만, 과제당 비용은 비교 대상 가운데 가장 높았다.
일부 하네스에서는 성능이 오히려 떨어졌다. 대규모 과제에서 오픈코드는 다른 환경보다 최대 9%포인트 낮은 점수를 기록했는데, 그중 절반가량은 출력 토큰 한도인 3만2000개에 도달해 코드 패치를 작성하기도 전에 실행이 중단된 사례였다. 반면 클로드 코드는 같은 한도에 이르면 모델에 출력을 계속하도록 자동 요청하는 회복 기능을 갖췄다.
하네스 선택은 비용에는 큰 차이를 만들었다. 같은 모델과 과제를 사용하더라도 하네스에 따라 과제당 비용이 최대 3배까지 벌어졌다. 비용 격차는 첫 번째 API 호출부터 나타났다. 시스템 프롬프트와 도구 정의에 포함된 고정 문맥의 크기가 클로드 코드는 1만개를 넘었지만, 미니-SWE-에이전트는 800토큰대에 그쳤다. 작업 단계가 많아질수록 이 차이로 인한 비용 부담도 커졌다.
가장 저렴한 하네스가 모든 모델에서 같지는 않았다. 딥시크 모델을 쓸 때는 미니-SWE-에이전트가 호출을 더 많이 하면서 비용 순위가 뒤집히는 예외도 있었다. 하네스의 비용 효율은 모델과 작업 방식이 어떻게 조합되는지에 따라 달라진다는 점을 보여준다.
연구진은 한 번의 실행 결과만으로 복잡한 하네스가 더 낫다고 판단해서는 안 된다고 강조했다. 실행 간 변동을 확인하려면 반복 검증을 하고 충분한 수의 과제를 확보해야 한다는 설명이다.
또한 복잡한 실행 환경을 무조건 도입하기보다 시스템 프롬프트와 도구 정의를 간소화하고, 실제로 사용하는 모델에서 비용과 성능을 반복 측정해 개선 효과가 확인된 기능만 남길 필요가 있다고 조언했다.